2x RTX 5060 Ti contra GB10: per què 32 GB de VRAM perden davant 128 GB de memòria unificada
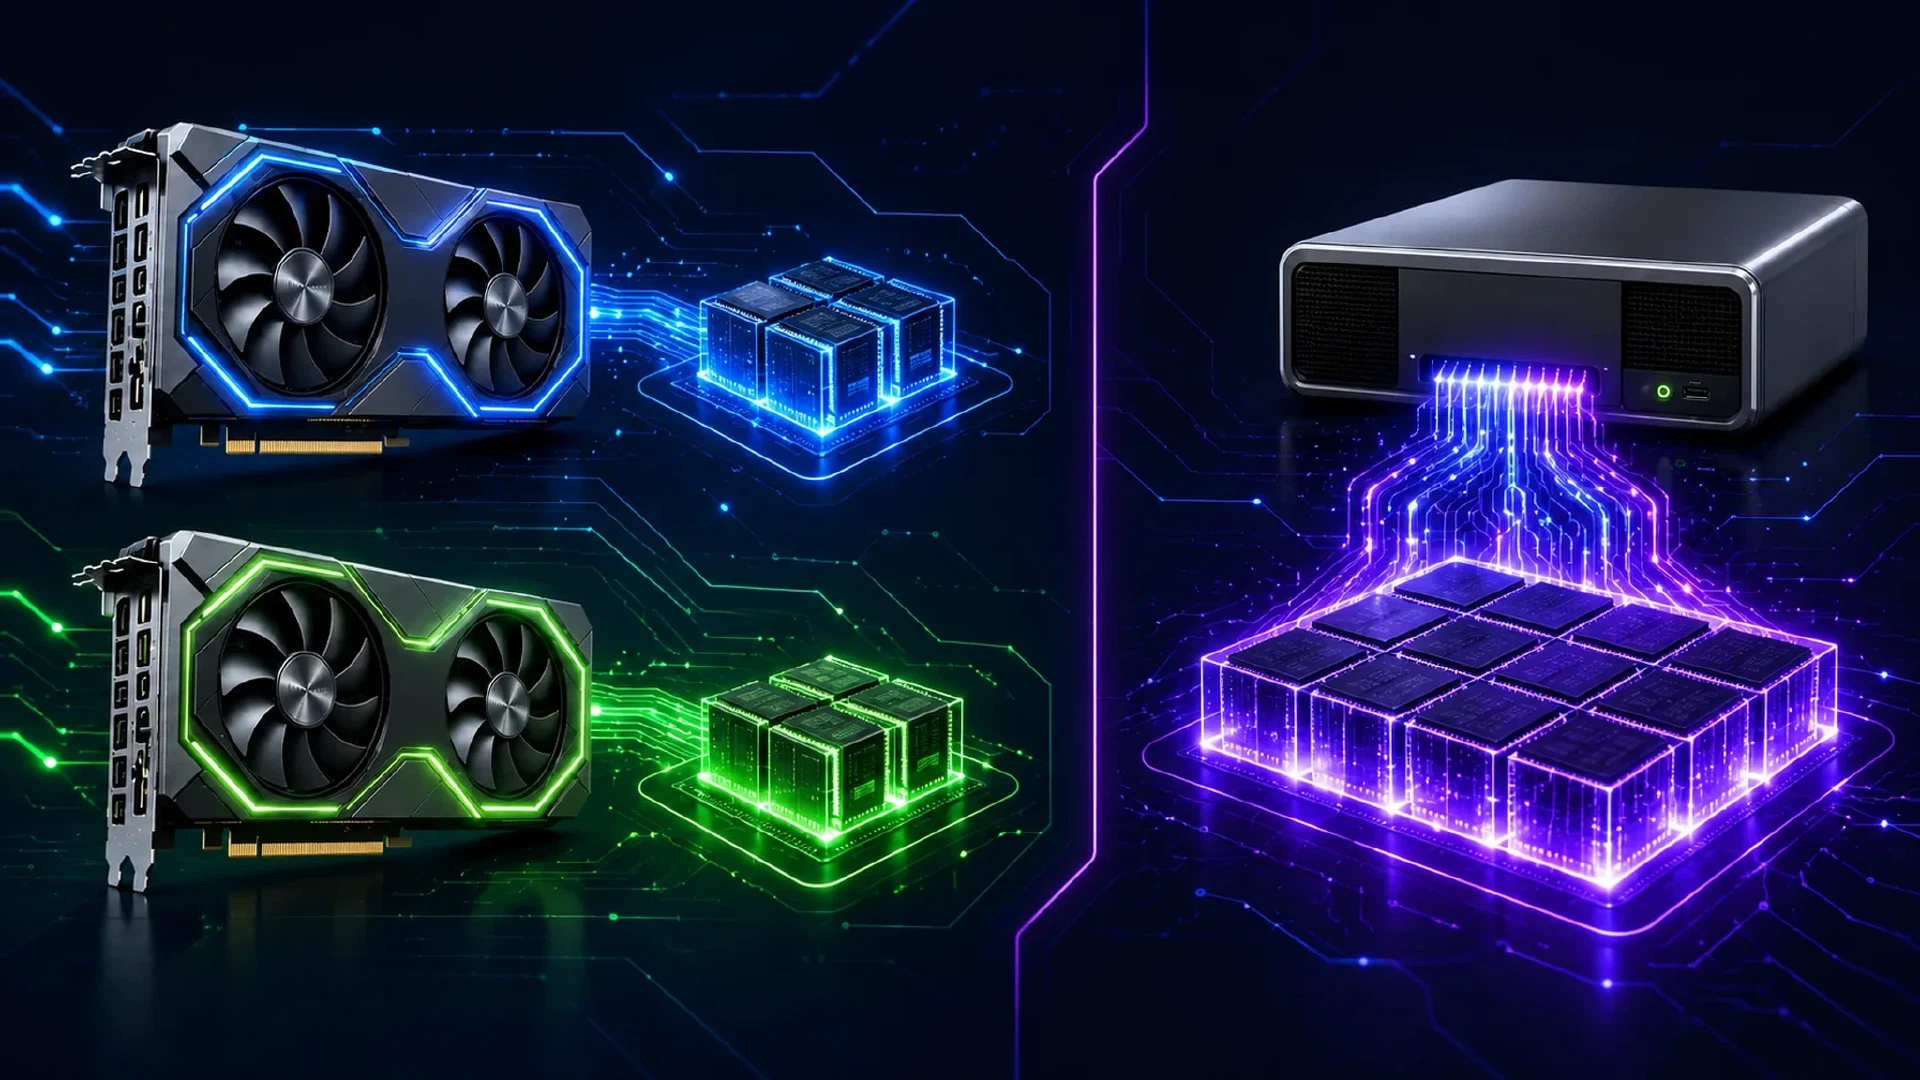
Table of Contents
Dues RTX 5060 Ti de 16 GB semblen atractives en una llista de peces. Ofereixen 32 GB de VRAM agregada i un processament ràpid de prompts amb context curt. La comparació canvia quan executes un model 27B amb context llarg.
El sistema NVIDIA GB10 utilitza 128 GB de memòria unificada coherent. NVIDIA indica 128 GB de memòria unificada LPDDR5x i una TDP de xip de 140 W per a la plataforma GB10. La RTX 5060 Ti utilitza 16 GB de GDDR7 per targeta, una interfície de memòria de 128 bits i una potència gràfica total de 180 W. Les especificacions de NVIDIA RTX 5060 Ti i les especificacions de NVIDIA GB10 mostren la diferència de maquinari.
La idea és simple. Dues targetes de 16 GB no creen un únic pool ràpid de 32 GB. Creen dos pools separats de 16 GB connectats pel sistema amfitrió. En la inferència de models grans, la capacitat disponible i el moviment de dades entre dispositius importen més que el nombre de targetes.
Comparació de memòria
| Sistema | Memòria | Model de memòria | Xifra de potència indicada |
|---|---|---|---|
| 2x RTX 5060 Ti 16 GB | 32 GB agregats | Dos pools de memòria GPU separats | 360 W de GPU total |
| Sistema GB10 | 128 GB | Memòria de sistema unificada coherent | 140 W de TDP del GB10 |
GB10 no guanya perquè 128 GB de LPDDR5x igualin l’amplada de banda d’una GPU discreta de gamma alta. L’avantatge prové de la capacitat i la ubicació. CPU i GPU comparteixen el mateix espai d’adreces. El model, els buffers d’execució, les activacions i les dades de context no han de cabre dins de dos dispositius aïllats de 16 GB.
El sistema de dues targetes té un problema de col·locació més difícil. El model s’ha de repartir entre les dues targetes. El runtime d’inferència ha de moure dades entre elles. El trànsit PCIe afegeix latència i consumeix amplada de banda. Segons NVIDIA, la RTX 5060 Ti tampoc admet NVLink.
Resultat del benchmark
Els resultats següents provenen de l’informe de benchmark d’IA proporcionat. L’informe compara un sistema dual-GPU sense nom, anomenat 5060ti-x2, amb un sistema GB10. La prova cobreix Qwen i GPT-OSS amb diverses mides de context.
Els models provenien directament d’Ollama. La prova va utilitzar les etiquetes predeterminades literals qwen3.8:27b i gpt-oss:latest, sense Modelfile personalitzat ni quantització alternativa. El sistema 5060ti-x2 va utilitzar PCIe Gen4 x16 i els controladors NVIDIA per a Linux més recents disponibles durant el benchmark.
Processament de prompts i generació de Qwen
| Context | Prompt 5060ti-x2 tok/s | Generació 5060ti-x2 tok/s | Prompt GB10 tok/s | Generació GB10 tok/s |
|---|---|---|---|---|
| 4K | 862.5 | 56.9 | 57.4 | 27.7 |
| 16K | 917.3 | 53.5 | 62.1 | 28.1 |
| 32K | 881.4 | 48.8 | 62.4 | 26.9 |
| 64K | 795.1 | 39.6 | 59.9 | 26.1 |
| 128K | 538.7 | 28.3 | 59.9 | 28.6 |
| 256K | 189.9 | 1.2 | 59.9 | 25.8 |
A 4K, el sistema de dues targetes genera aproximadament el doble de ràpid que GB10. A 64K, l’avantatge baixa a unes 1,5 vegades. A 128K, els dos sistemes arriben a una velocitat de generació semblant.
A 256K, la comparació deixa d’afavorir la configuració de dues targetes. La sol·licitud 5060ti-x2 només va arribar a 171.359 tokens de prompt reals. La generació va baixar a 1,2 tokens per segon. GB10 va completar la prova sencera de 256K a 25,8 tokens per segon.
GB10 va generar unes 21,5 vegades més ràpid en el resultat provat de 256K. Més important, GB10 va completar el context sol·licitat. El sistema de dues targetes no va lliurar la mateixa càrrega.
Per què la VRAM agregada és enganyosa
1. El model no veu una targeta de 32 GB
Dues GPU no fusionen la memòria en un únic espai d’adreces local. Un runtime paral·lel divideix capes o tensors entre dispositius. Cada dispositiu continua necessitant espai per als pesos assignats, els buffers temporals i una part de l’estat del context.
La capacitat utilitzable és inferior a la suma simple. La sobrecàrrega exacta depèn del format del model, la quantització, el backend d’inferència, la divisió de tensors i la longitud del context.
2. La memòria de context creix durant la generació
Els pesos del model només són una part del pressupost de memòria. La memòria cau de claus i valors, o KV cache, guarda dades d’atenció dels tokens anteriors. Els contextos llargs necessiten més memòria cau. Una prova de 4K no prediu un desplegament de 128K o 256K.
Els resultats mostren aquest límit. El sistema de dues targetes manté un avantatge clar en el processament de prompts i després perd rendiment de generació a mesura que creix el context. GB10 es manté prop de 26 a 29 tokens de generació per segon entre 4K i 256K.
3. Les transferències PCIe afegeixen un cost
Quan el runtime mou activacions o tensors entre GPU, la transferència travessa la interconnexió de l’amfitrió. Això crea punts de sincronització i afegeix latència a cada pas. La penalització creix quan la càrrega travessa sovint el límit entre dispositius.
Això no fa inútil un sistema dual-GPU. La ubicació de memòria forma part del resultat de rendiment. Un benchmark que només informa del processament de prompts a 4K omet aquest cost.
4. L’eficiència energètica és un avantatge del sistema
GB10 utilitza menys energia en la comparació i ofereix més capacitat de memòria per a la càrrega de context llarg provada. Dues RTX 5060 Ti sumen 360 W de potència de GPU abans de comptar la resta del sistema. NVIDIA indica una TDP de 140 W per a GB10.
GB10 canvia la velocitat màxima de context curt per capacitat, finalització i menys potència de GPU. Aquestes compensacions importen en la inferència Qwen amb context llarg.
El sistema 5060ti-x2 costa molt menys
La comparació de rendiment no elimina la diferència de preu. Una estació de treball completa amb dues RTX 5060 Ti de 16 GB apareixia a 3.479 dòlars el 10 d’octubre de 2026. Inclou Intel Ultra 7 265K, placa Z890, 32 GB de DDR5, 1 TB d’emmagatzematge, una font de 1.000 W i les dues GPU. Consulta la llista completa de l’estació dual-GPU .
El marketplace nord-americà de NVIDIA llista la DGX Spark de 128 GB a 6.950 dòlars. Inclou 128 GB de memòria unificada coherent i 4 TB NVMe, però el sistema apareix sense existències. Consulta la llista actual de DGX Spark de NVIDIA .
La AMD Ryzen AI Halo Developer Platform ofereix un altre punt de comparació. Aquest sistema Strix Halo costa 3.999,99 dòlars a Micro Center, amb 128 GB de memòria unificada LPDDR5x i 2 TB d’emmagatzematge. Strix Halo sol quedar dins de la mateixa classe pràctica d’IA local que els sistemes GB10, encara que les proves independents sovint mesuren GB10 per davant en rendiment i maduresa del programari. Consulta la llista Linux actual de Micro Center i llegeix la ressenya de Strix Halo contra GB10 .
| Sistema complet | Preu llistat el 10 d’octubre de 2026 | Diferència de preu |
|---|---|---|
| Estació 5060ti-x2 | $3,479 | Base |
| AMD Ryzen AI Halo, Strix Halo | $3,999.99 | $520.99 més |
| GB10 DGX Spark de 128 GB | $6,950 | $3,471 més |
GB10 ofereix un pool de memòria unificada més gran, menys consum i una arquitectura millor per a context llarg. El sistema AMD ofereix la mateixa classe de memòria de 128 GB per uns 4.000 dòlars. L’estació 5060ti-x2 continua al voltant del 50% del preu llistat de GB10, abans d’impostos i enviament. Els compradors que necessiten memòria unificada però no el stack de programari de NVIDIA tenen una alternativa més econòmica amb Strix Halo.
Aquests són preus llistats per venedors diferents, no una cistella minorista controlada. La comparació també deixa el 5060ti-x2 amb menys memòria de sistema i emmagatzematge. La diferència continua sent important perquè les dues llistes descriuen ordinadors complets i utilitzables, no preus de GPU soles. Les targetes RTX 5060 Ti de 16 GB se situen prop de 789 a 830 dòlars cadascuna, molt per sobre del MSRP de llançament de 429 dòlars. L’avantatge de preu de dues targetes persisteix durant l’actual pujada de preus de GPU. Preus actuals de RTX 5060 Ti .
El resultat GPT-OSS necessita un tractament separat
El mateix informe mostra una generació forta de GPT-OSS al 5060ti-x2 entre 4K i 256K. GB10 completa les proves de 4K a 128K, però la prova GPT-OSS de 256K apareix com a no compatible.
No utilitzis la taula GPT-OSS per afirmar un guanyador universal. Les proves no cobreixen el mateix rang a 256K. El resultat Qwen ofereix la comparació de context llarg més neta perquè els dos sistemes informen d’un resultat a 256K, encara que l’execució 5060ti-x2 només va arribar a 171.359 tokens de prompt reals.
Què significa per a un equip Qwen 3 27B
Una configuració de dues targetes de 16 GB podria executar un model 27B quantitzat amb un context més petit. El benchmark no refuta aquest ús. Les dades refuten la idea que 32 GB de VRAM agregada ofereixin el mateix marge pràctic que un sistema amb 128 GB de memòria unificada.
Que un model càpiga en una targeta només demostra la capacitat dels pesos. El requisit real inclou pesos, context actiu, KV cache, buffers d’execució i marge del sistema operatiu. El context ha de cabre al costat del model. Un model que carrega però no té espai per a la conversa de treball no és una configuració útil de context llarg.
Això coincideix amb la guia de dimensionament de Són suficients 16GB de VRAM per treballar seriosament amb LLM locals? , que tracta pesos, context i assignacions del runtime com un pressupost únic. La guia de 32GB de VRAM per a Qwen 27B arriba a la mateixa conclusió per a equips de dues targetes. La capacitat agregada no equival al marge utilitzable.
Abans de comprar maquinari per a un desplegament Qwen 3 27B, respon quatre preguntes:
- La quantització sol·licitada hi cap amb els buffers del runtime? Els pesos sols no defineixen la memòria necessària.
- El context hi cap sense una pressió greu sobre la KV cache? Els prompts llargs canvien el resultat.
- El runtime utilitza una divisió ràpida dels dispositius? Les transferències PCIe i la ubicació dels tensors afecten cada token generat.
- El sistema completa el context objectiu? Un resultat ràpid a 4K no compensa una càrrega fallida a 256K.
La prova proporcionada respon l’última pregunta per al sistema de dues targetes. L’execució va arribar a 171.359 tokens durant la sol·licitud Qwen de 256K i va generar a 1,2 tokens per segon. GB10 va completar 256K a 25,8 tokens per segon.
Per a aquesta càrrega de context llarg, la memòria unificada és la millor arquitectura quan l’alternativa depèn de PCIe per cobrir el conjunt de treball del model. PCIe continua sent una solució de capacitat. No crea el mateix pool de memòria, latència ni camí de transferència. La guia de context de GPU per a IA local explica per què pesos, KV cache, sortida d’eines i buffers s’han de dimensionar junts. El benchmark de GPU d’Ollama Qwen3.8 27B també explica per què els resultats de context llarg necessiten una atenció separada de les xifres de decodificació amb context curt.
Veredicte
Dues RTX 5060 Ti de 16 GB són un substitut deficient de GB10 quan l’objectiu és la inferència 27B amb context llarg. Ofereixen més rendiment de prompts amb contextos curts. També consumeixen més potència de GPU i exposen el runtime a un esquema de memòria dividida.
GB10 és més lent processant prompts en els resultats proporcionats. El sistema és més eficient, ofereix quatre vegades la memòria agregada i completa la prova Qwen de 256K amb una velocitat de generació útil.
Si executes prompts curts i valores la ingestió de prompts, 5060ti-x2 té un cas d’ús limitat. Per a un model 27B, el pool de memòria unificada més gran és millor perquè model i context comparteixen un únic conjunt de treball coherent. La memòria unificada continua sent preferible quan les transferències PCIe entren en el camí d’inferència.
El benchmark no demostra que dues RTX 5060 Ti no iniciïn mai Qwen 3 27B. Les dades mostren per què iniciar el model és diferent d’executar bé la càrrega.
Límits del benchmark
L’informe identifica les etiquetes literals d’Ollama, però no registra els manifests resolts, les revisions del model, la CPU, les mesures de potència ni la refrigeració. També identifica PCIe Gen4 x16 per al sistema 5060ti-x2 i els controladors NVIDIA Linux actuals durant la prova. Tracta les xifres com una comparació de sistemes observats, no com una classificació universal de cada parell RTX 5060 Ti i cada implementació GB10.
Les especificacions de maquinari provenen de NVIDIA. Les xifres de rendiment provenen de les dades de benchmark proporcionades per a aquest article.
Referències
- Biblioteca de models Qwen3.8 d’Ollama
- Etiquetes de models GPT-OSS d’Ollama
- Són suficients 16GB de VRAM per treballar seriosament amb LLM locals?
- 32GB de VRAM per a Qwen 27B
- Guia de context de GPU per a IA local
- Benchmarks de GPU de Qwen3.8 27B a Vast.ai
- Llista completa de l’estació amb dues RTX 5060 Ti de 16 GB
- Llista de NVIDIA DGX Spark al marketplace dels EUA
- Llista Linux AMD Ryzen AI Halo de 128 GB
- Ressenya de Tom’s Hardware sobre Strix Halo contra GB10
- Preus actuals de RTX 5060 Ti
Related Posts