

Certificacions de ciberseguretat en IA: no segueixen el ritme

Table of Contents
Vam fer els exàmens. Els vam aprovar. Vam obtenir certificats, però també un grau de decepció que vull descriure amb precisió.
No és una queixa sobre les persones que van crear aquests programes. Treballen amb materials incomplets. La seguretat de la IA és una disciplina jove. La recerca sobre atacs avança més de pressa que les eines defensives. Els marcs de governança van arribar abans que les orientacions d’enginyeria.
El problema és la distància entre el que ensenyen les certificacions i el que cal saber per protegir de debò els sistemes d’IA en producció.
Tres capes que sovint es confonen
Abans d’explicar què hi falta, convé separar el que ja existeix.
La primera capa és la governança. Documents com NIST AI Risk Management Framework (AI RMF 1.0, 2023), ISO/IEC 42001:2023 i EU AI Act actuen a escala d’organització i de procés. Descriuen com gestionar el risc d’IA, estructurar la supervisió i documentar la responsabilitat. Se centren expressament en la governança, no en prescriure controls tècnics. És una decisió de disseny.
La segona capa és la taxonomia d’amenaces. MITRE ATLAS documenta tàctiques adversàries contra sistemes d’IA amb el mateix format que ATT&CK. OWASP Top 10 for Large Language Model Applications enumera les classes d’atac més rellevants per als LLM desplegats. Aquests documents anomenen els atacs i descriuen com funcionen. No prescriuen defenses.
La tercera capa és l’orientació tècnica. Inclou Google’s Secure AI Framework (SAIF), Microsoft’s AI Security SDL, OWASP AI Exchange, NIST AI 600-1 (Generative AI Profile) i documentació de seguretat específica de proveïdors com Anthropic, OpenAI i Meta. Aquests recursos ofereixen orientació d’enginyeria sobre desplegament segur, pràctiques d’avaluació i controls en temps d’execució.
La majoria de certificacions de governança d’IA cobreixen a fons la primera capa. Esmenten la segona a nivell general. Rarament tracten la tercera.
Què cobreixen les certificacions
Les certificacions de governança i seguretat d’IA disponibles avui, com IAPP AI Governance Professional (AIGP), ISACA AI Fundamentals Certificate, les certificacions ISO 42001 i CompTIA AI+, cobreixen un conjunt semblant de temes.
Aprens NIST AI RMF i com relacionar-ne les quatre funcions, Govern, Map, Measure i Manage, amb el desplegament d’IA de la teva organització. Aprens la classificació dels nivells de risc d’EU AI Act i en què consisteix l’avaluació de conformitat per als sistemes d’alt risc. Aprens els principis de governança de biaix, equitat, transparència i responsabilitat. També aprens a redactar polítiques de governança d’IA i a fer avaluacions d’impacte.
Són habilitats reals. Les organitzacions necessiten persones que entenguin els marcs de governança, llegeixin NIST AI RMF i sàpiguen què els demana construir.
Les certificacions no ensenyen amb la mateixa profunditat:
- Com comprometen els atacants els sistemes d’IA en producció avui
- Com és operativament la defensa en profunditat contra la injecció de prompt i per què cap control únic no l’elimina
- Com verificar la integritat dels models abans del desplegament
- Què inclou el red teaming específic d’IA i com definir-ne l’abast
- Com avaluar el comportament d’un model davant d’entrades adversàries abans del llançament
- Com és l’observabilitat d’IA durant la inferència
- En què es diferencia la resposta a incidents d’IA dels procediments habituals d’IR
- Què cal per protegir agents d’IA amb accés a eines i integracions externes
NIST AI RMF és governança, no enginyeria
NIST AI RMF és un document ben construït. NIST el va dissenyar perquè fos neutral respecte a la tecnologia, independent del sector i aplicable a diferents enfocaments de desenvolupament d’IA. Això permet aplicar el marc a molts casos.
També vol dir que no prescriu controls tècnics per a classes d’atac concretes. Si la teva organització adopta completament AI RMF i en relaciona totes les funcions amb el desplegament d’IA, tindrà processos de risc documentats. No necessàriament tindrà una defensa contra la injecció de prompt en el model de llenguatge desplegat.
NIST ho reconeix. NIST AI 600-1, Generative AI Profile, publicat el 2024, amplia AI RMF específicament per a IA generativa i models de llenguatge grans. Cobreix riscos com la injecció de prompt, l’enverinament de dades i els perills informatius amb un grau de detall que el marc AI RMF bàsic no assoleix. Si la teva certificació va cobrir AI RMF bàsic sense AI 600-1, et vas perdre el document més rellevant per als sistemes desplegats actualment.
ISO 42001 i la comparació amb els sistemes de gestió
ISO 42001:2023 és un estàndard de sistema de gestió d’IA. Proporciona una estructura per governar el desenvolupament i el desplegament d’IA a escala organitzativa. Els professionals de la seguretat hi reconeixeran el paral·lel amb ISO 27001, de seguretat de la informació.
ISO 27001 s’adopta àmpliament. Les organitzacions certificades encara pateixen intrusions. La certificació documenta que existeix un sistema de gestió, que segueix un procés definit i que es revisa. No certifica que els sistemes gestionats amb aquest procés resisteixin els atacs que reben.
ISO 42001 aporta disciplina organitzativa. La certificació comunica a les parts interessades que els processos d’IA estan documentats, revisats i sotmesos a governança. No demostra que els models desplegats produeixin resultats coherents en condicions adversàries, que els agents respectin els límits de confiança definits o que els models ajustats s’hagin creat amb dades d’entrenament verificades.
És la mateixa distància que hi ha amb ISO 27001. En ciberseguretat tradicional vam aprendre a conviure-hi. No hauríem de fingir que les certificacions de governança d’IA la resolen quan comparteixen la mateixa limitació estructural.
EU AI Act exigeix resultats, però no especifica l’enginyeria
EU AI Act classifica els sistemes d’IA segons el risc: inacceptable (prohibit), alt (requereix avaluació de conformitat), limitat (obligacions de transparència) i mínim (sense requisits específics).
Els sistemes d’alt risc, com els d’infraestructura crítica, identificació biomètrica, selecció de personal, educació i aplicació de la llei, han de complir requisits de documentació tècnica, supervisió humana i robustesa. La llei exigeix explícitament que aquests sistemes resisteixin intents de canviar-ne el comportament mitjançant manipulació adversària.
El requisit apareix al text legal. La llei especifica intencionadament els resultats, no els controls tècnics. Encara no hi ha consens sobre mètodes per demostrar robustesa adversària en tots els contextos de desplegament, tipus de sistema i casos d’ús.
Les certificacions basades en EU AI Act et preparen per classificar sistemes d’IA, redactar documentació tècnica i estructurar protocols de supervisió. Et preparen per a les auditories. La feina d’enginyeria per crear un sistema que compleixi els requisits de robustesa pertany a una disciplina diferent de la que cobreixen les certificacions actuals.
Què ataca realment els sistemes d’IA
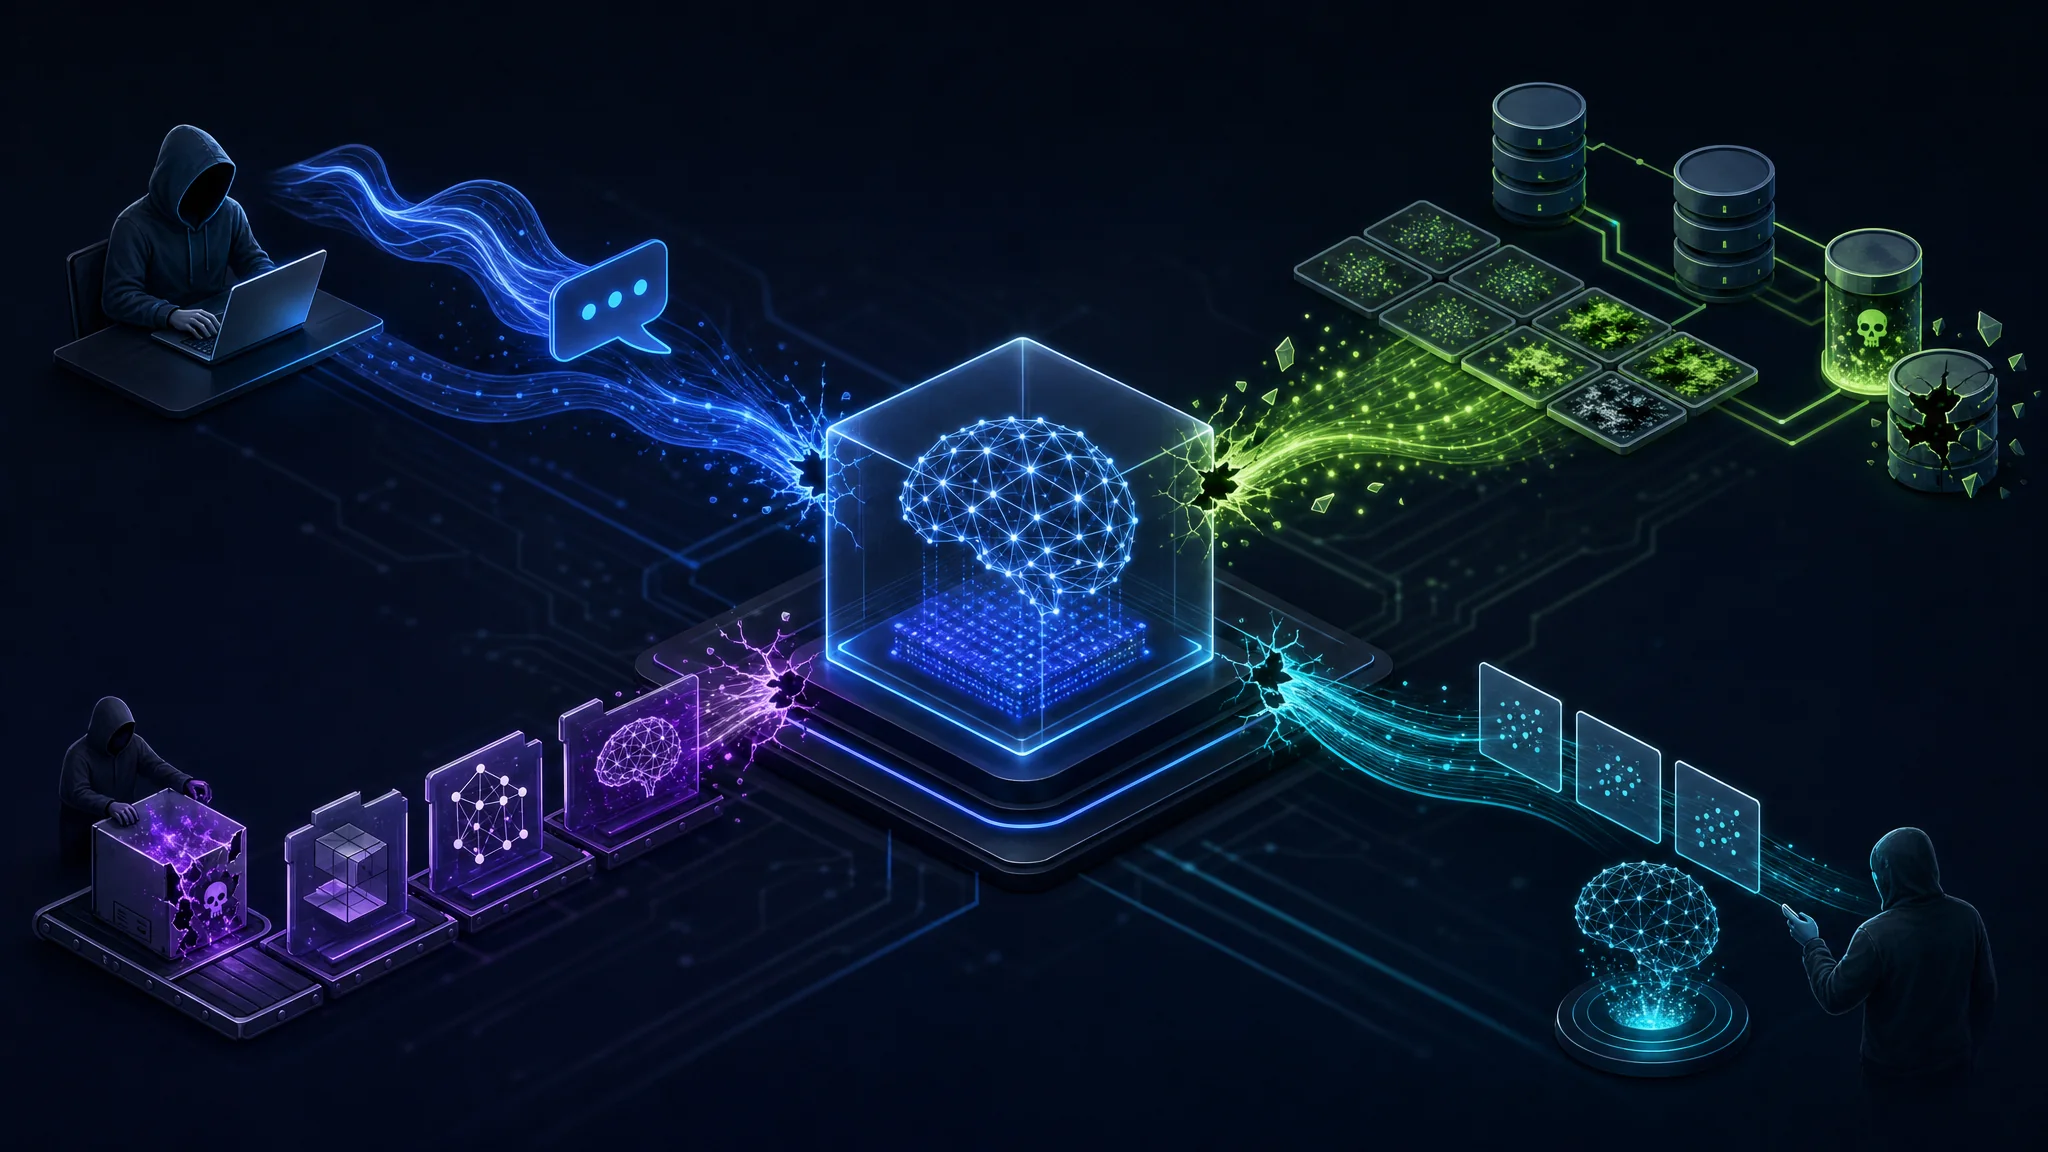
MITRE ATLAS i OWASP LLM Top 10 documenten el panorama operatiu de les amenaces. Són recursos que enumeren atacs amb un nivell de detall útil. Els marcs de governança esmenten les amenaces de manera més abstracta. El contingut següent prové d’aquestes fonts específiques de seguretat.
La injecció de prompt funciona proporcionant a un model de llenguatge una entrada que sobreescriu o manipula les instruccions del sistema. La injecció directa apunta directament a l’entrada del model. La indirecta amaga instruccions malicioses en contingut que el model recupera, processa o resumeix. La teva pipeline RAG llegeix un document controlat per l’atacant i executa les instruccions que hi ha amagades. L’agent de navegació visita una pàgina controlada per l’atacant i segueix les instruccions incorporades. El bot d’atenció al client resumeix un article que li diu que ignori les directrius de seguretat.
El 2026 no hi ha cap mitigació universalment efectiva contra la injecció de prompt. La defensa en profunditat redueix el risc amb filtratge de les entrades, validació de les sortides, permisos limitats per a les eines, entorns d’execució aïllats i aprovació humana per a les accions importants. Cap d’aquestes mesures elimina la classe d’atac. NIST, OWASP, Anthropic, OpenAI, Google i Microsoft recomanen controls per capes en lloc d’una solució única.
L’enverinament de dades d’entrenament introdueix exemples maliciosos a les dades per degradar el comportament del model, afegir portes del darrere o implantar comportaments activats per un senyal. Sovint no hi ha indicis de l’enverinament fins que el model rep una entrada desencadenant concreta. Si l’organització ajusta models amb contingut creat per usuaris, documents recuperats o conjunts de dades de tercers sense verificar-ne la procedència, està exposada a aquest risc.
La compromissió de la cadena de subministrament de models és una amenaça que moltes organitzacions tracten com una qüestió secundària. Els repositoris de models sovint distribueixen codi executable al costat dels pesos dels models. Formats de serialització insegurs com pickle han creat repetidament riscos a la cadena de subministrament. Els paquets que acompanyen les descàrregues de models poden instal·lar dependències vulnerables. Moltes organitzacions semblen examinar molt menys els models de repositoris públics que les dependències de programari. La superfície d’atac és comparable a npm, però la cultura de seguretat del sector encara és incipient.
L’extracció de models permet als atacants reconstruir models funcionalment semblants mitjançant consultes d’inferència repetides a la teva API. Això provoca una pèrdua de propietat intel·lectual i permet estudiar el model fora de línia per desenvolupar atacs més dirigits.
La inferència de pertinença permet als atacants determinar, amb diversos nivells de confiança, si registres concrets formaven part del conjunt d’entrenament. Depèn de l’arquitectura del model i del règim d’entrenament. Crea un risc de privadesa per a les organitzacions que han entrenat amb informació personal.
Les entrades adversàries manipulen les sortides del model amb pertorbacions dissenyades expressament. La tècnica s’estudia sobretot en classificació d’imatges, però també s’aplica a text, àudio i sistemes multimodals. Si la teva IA decideix sobre detecció de frau, solvència creditícia, imatges mèdiques o accés físic, la robustesa adversària és una propietat de seguretat que cal posar a prova, no només documentar.
Les fuites de dades pels sistemes d’IA requereixen atenció directa. Les pipelines RAG exposen documents de la base de coneixement, de vegades a usuaris que no hi haurien de tenir accés. La filtració de prompts d’instruccions del sistema revela detalls operatius que volies mantenir confidencials. Els desplegaments d’IA multiinquilí requereixen aïllament, que els enginyers tradicionals de seguretat d’aplicacions de vegades infravaloren. Són riscos operatius habituals en sistemes desplegats.
Els agents d’IA canvien completament la superfície d’atac
La majoria de certificacions de seguretat d’IA es van escriure quan els sistemes d’IA eren sobretot xatbots i classificadors. El 2026, la IA empresarial cada cop vol dir més agents.
Els agents es diferencien dels xatbots en un aspecte operatiu important: actuen. Un agent amb accés a eines de correu electrònic, bases de dades internes, sistemes de fitxers, navegador i execució de codi no és un xatbot amb més funcions. És un procés autònom amb accés important a sistemes reals, que actua a partir de les sortides d’un model de llenguatge.
OWASP ara manté un Agentic AI Top 10 separat perquè el model d’amenaces dels agents difereix prou de les aplicacions de xat LLM per requerir documentació específica.
En un agent, la injecció de prompt no produeix una resposta de text no desitjada. Produeix una acció no desitjada. Una instrucció indirecta en un document recuperat pot dir a l’agent que elimini fitxers, extregui dades o enviï correus electrònics. La conseqüència no és una resposta inadequada, sinó una acció no autoritzada contra sistemes accessibles per a l’agent.
La superfície d’atac dels agents inclou:
- Límits de crides a eines: si l’agent està restringit a les eines mínimes adequades per a cada tasca
- Abast de les credencials: si les credencials de l’agent es limiten al que requereix cada tasca
- Reversibilitat de les accions: si les accions importants necessiten aprovació humana abans d’executar-se
- Filtratge de sortides: si se’n validen les sortides abans que activin accions posteriors
- Aïllament: si l’entorn d’execució impedeix l’accés accidental als sistemes connectats
La majoria de certificacions de governança d’IA no tracten el disseny de seguretat dels agents amb aquest nivell de detall.
Model Context Protocol crea una nova superfície d’atac empresarial
Model Context Protocol (MCP) s’ha convertit en un estàndard estès per connectar agents d’IA a eines, fonts de dades i serveis externs. Els servidors MCP exposen capacitats que els agents descobreixen i utilitzen. La integració és ràpida i flexible, però les implicacions de seguretat no sempre reben la mateixa atenció.
Els riscos específics de MCP inclouen:
- Servidors MCP maliciosos que descriuen incorrectament les seves capacitats i executen accions no desitjades
- Enverinament d’eines, en què un servidor MCP legítim retorna dades controlades per l’atacant i hi incorpora instruccions quan hauria de retornar només dades
- Eines amb massa privilegis, quan les integracions MCP tenen permisos per sobre del que requereix la tasca
- Confusió dels límits de confiança, quan els agents tracten les instruccions de les eines MCP connectades com si fossin instruccions de l’usuari
Les organitzacions que despleguen agents amb integracions MCP necessiten un marc per avaluar la confiança en els servidors MCP, auditar els permisos de les eines i validar que les respostes de les eines es tracten com a dades, no com a instruccions.
L’avaluació és la pràctica operativa que les certificacions ometen
El red teaming d’IA i les suites d’avaluació substitueixen les avaluacions estàtiques de seguretat com a mètodes principals per entendre el risc dels models abans i després del desplegament.
El red teaming d’IA inclou:
- Proves adversàries estructurades del comportament del model contra tècniques d’atac conegudes
- Benchmarking de jailbreaks amb conjunts de dades establerts d’atacs de prompt
- Proves de robustesa adversària que mesuren la variació de les sortides davant d’entrades pertorbades
- Proves de regressió del comportament entre versions del model
- Avaluació de benchmarks de seguretat amb suites publicades
NIST, Anthropic, OpenAI, Microsoft, Google i CISA recomanen red teaming específic d’IA abans de desplegar sistemes d’alt risc. S’està convertint en una pràctica estàndard, no opcional.
Cap certificació actual de governança d’IA no prepara prou els professionals per definir l’abast, executar o interpretar un exercici de red teaming contra un model o agent desplegat. Expliquen què és el red teaming, però no ensenyen a fer-lo.
L’observabilitat d’IA és una disciplina independent
Els registres de seguretat tradicionals no es poden traslladar directament als sistemes d’IA. Monitorar un LLM o un agent en producció requereix recollir dades diferents i analitzar-les d’una altra manera.
La infraestructura d’observabilitat d’IA inclou:
- Telemetria de prompts i sortides per detectar anomalies i identificar infraccions de polítiques
- Registres de crides a eines per als agents, amb les eines i els arguments utilitzats
- Monitoratge de la qualitat de recuperació en pipelines RAG
- Detecció i classificació d’intents de jailbreak
- Monitoratge de la coherència de les sortides per detectar drift entre versions del model
- Seguiment de la taxa d’al·lucinació en aplicacions on la precisió factual és important
- Patrons de latència que poden indicar intents d’injecció de prompt que augmenten la mida del context
És una disciplina emergent. El 2026, la majoria d’organitzacions que despleguen IA tenen molta menys observabilitat dels components d’IA que de la infraestructura tradicional. La majoria de certificacions de governança no descriuen com hauria de ser una observabilitat adequada dels sistemes d’IA.
La resposta a incidents d’IA no és com la resposta tradicional
Quan es compromet un sistema tradicional, el playbook d’IR cobreix contenció, anàlisi forense i recuperació. Els incidents d’IA plantegen preguntes que el playbook estàndard no resol.
Prepara procediments per a aquestes preguntes abans de necessitar-los:
- Com determinar si un model es va enverinar durant el fine-tuning
- Com avaluar si s’ha abusat d’una recuperació RAG per retornar contingut controlat per l’atacant
- Com identificar si un agent ha executat accions no autoritzades i quin n’ha estat l’abast
- Com verificar si una actualització del model d’un proveïdor extern n’ha canviat el comportament de manera rellevant per a la seguretat
- Com establir quin era el comportament del model abans d’un incident per comparar-lo amb el comportament posterior
Això requereix preparació prèvia a l’incident, registres i telemetria configurats amb antelació, i runbooks específics d’IA amb espai per a l’anàlisi forense del comportament del model, no només del trànsit de xarxa i els registres dels endpoints.
El problema d’actualitzar les certificacions
Una raó estructural per la qual les certificacions no segueixen la pràctica és que la seguretat d’IA canvia més de pressa del que permeten els cicles d’actualització.
Security+, CISSP i ISO 27001 cobreixen àmbits que evolucionen al llarg dels anys. Les superfícies d’atac principals de xarxes, endpoints i aplicacions són relativament estables. Les tècniques d’atac a la IA evolucionen en mesos. Les tècniques d’injecció de prompt, els mètodes d’atac adversari i les superfícies d’atac agèntic del 2026 són diferents de les existents quan es van llançar les primeres certificacions d’IA, el 2023 i el 2024.
Els organismes de certificació actualitzen els materials segons un calendari. OWASP LLM Top 10 va publicar una revisió important durant el primer any. MCP no era una preocupació empresarial quan es van dissenyar moltes certificacions actuals d’IA. Els marcs de seguretat d’IA agèntica són posteriors a la majoria dels currículums actuals.
És un problema estructural, no una manca d’intenció. Llegeix fonts primàries de manera continuada en lloc de tractar una certificació com un bloc de coneixement fix.
Què ha d’incloure el contingut de les certificacions de seguretat d’IA
Per reflectir la pràctica actual de seguretat d’IA, els currículums de certificació han de cobrir:
- Defensa en profunditat contra la injecció de prompt: filtratge d’entrades, validació de sortides, limitació d’eines, aïllament i aprovació humana, amb les limitacions documentades de cadascuna
- Verificació de la cadena de subministrament dels models: riscos de serialització insegura, requisits d’SBOM, documentació de procedència i verificació d’artefactes signats
- Arquitectura de seguretat d’agents d’IA: límits de confiança, accés mínim a eines, reversibilitat d’accions i requisits de monitoratge
- Seguretat de MCP i de les integracions externes: avaluació de confiança dels servidors d’eines, auditoria de permisos i separació de dades i instruccions
- Avaluació i red teaming: com definir l’abast d’una avaluació adversària, quins benchmarks i conjunts de dades existeixen i com interpretar els resultats
- Observabilitat d’IA: registres i telemetria necessaris i ús per detectar i respondre a incidents
- Resposta a incidents específica d’IA: planificació prèvia d’escenaris, recollida de proves sobre el comportament del model i consideracions de recuperació específiques
- Prevenció de fuites de dades: aïllament RAG, confidencialitat dels prompts, controls d’accés multiinquilí i filtratge de sortides
Què has de fer ara mateix
Si ets responsable dels sistemes d’IA de la teva organització:
Llegeix OWASP Top 10 for Large Language Model Applications i OWASP Agentic AI Top 10. Són gratuïts i més específics en l’àmbit operatiu que els currículums de certificació de pagament actuals.
Revisa MITRE ATLAS abans de la propera sessió de modelatge d’amenaces d’un component d’IA. Abans de tancar el disseny de desplegament, identifica quines tàctiques adversàries s’apliquen a la teva arquitectura.
Llegeix NIST AI 600-1. Amplia el marc AI RMF bàsic específicament per a la IA generativa i és molt més rellevant per als desplegaments de LLM i agents que el marc bàsic per si sol.
Consulta Google SAIF, Microsoft’s AI SDL i OWASP AI Exchange per obtenir orientació d’enginyeria que els marcs de governança no proporcionen.
Verifica la procedència de cada model que desplega la teva organització. Consulta les targetes dels models. Abans de carregar els pesos, escaneja els formats de serialització per detectar classes d’explotació conegudes.
Relaciona cada agent d’IA del teu entorn amb els accessos que té. Un agent amb accés de lectura i escriptura a la base de coneixement interna, al correu electrònic i al sistema de fitxers amplifica la injecció de prompt. Limita les seves credencials al que requereixi cada tasca.
Exigeix red teaming específic d’IA abans de desplegar qualsevol model o agent en un context d’alt impacte. Considera-ho obligatori.
Prepara ara runbooks de resposta a incidents específics d’IA, abans de necessitar-los.
Tracta la certificació de governança com a documentació de la capa de processos. No documenta la teva postura de seguretat.
Referències
- NIST AI Risk Management Framework (AI RMF 1.0), 2023
- NIST AI 600-1: Generative AI Profile, 2024
- NIST SP 1270: Towards a Standard for Identifying and Managing Bias in Artificial Intelligence
- ISO/IEC 42001:2023 Artificial Intelligence Management Systems
- EU AI Act, Regulation (EU) 2024/1689
- OWASP Top 10 for Large Language Model Applications, 2025
- OWASP Agentic AI Top 10
- OWASP AI Exchange
- MITRE ATLAS: Adversarial Threat Landscape for AI Systems
- Google Secure AI Framework (SAIF)
- Microsoft AI Security SDL documentation
- CISA Guidance on AI Cybersecurity, 2024
- Barreno et al., Can Machine Learning Be Secure?, 2006
- Biggio et al., Poisoning Attacks Against Support Vector Machines, 2012
- Goodfellow et al., Explaining and Harnessing Adversarial Examples, ICLR 2015
- IAPP AI Governance Professional (AIGP) program documentation
- ISACA AI Fundamentals Certificate program documentation
