Dins de la nostra flota híbrida d’agents d’IA: Hermes, LiteLLM i Tailscale

Table of Contents
Hem desplegat una flota local de GPU assignades per sol·licitud i n’hem dissenyat el pla de control híbrid. El camí verificat comença a LiteLLM, selecciona un grup de models i carrega un model local en una GPU cada vegada. La política de nivells de Hermes és una proposta, i un artefacte de configuració de Tailscale Aperture està preparat per a la propera prova d’integració. Cap dels dos no s’ha verificat com a part d’un únic recorregut complet d’extrem a extrem.
Les targetes inactives minen Pearl. Una sol·licitud d’IA atura la mineria només a la targeta llogada, atén la sol·licitud, descarrega el model i retorna la targeta al miner.
Idees principals
- T0 a T2 gestionen les tasques costoses o exigents. Aquests recorreguts prioritzen models allotjats de frontera i cadenes de contingència ordenades.
- T3 gestiona feina local substancial. La flota assigna la planificació, la programació, la revisió i la visió a models de 4B a 12B.
- T4 gestiona feina local freqüent. Els models petits encaminen, classifiquen, extreuen, generen embeddings i completen tasques de codi delimitades.
- Cada GPU és un recurs independent. Una targeta atén la IA mentre la resta continuen minant.
- Els models locals romanen descarregats quan no s’utilitzen. Cap model conserva memòria GPU entre finestres de sol·licitud.
- Cada passarel·la exposa el mateix catàleg lògic. Els àlies compartits distribueixen la feina entre sistemes aptes. Els àlies prefixats amb el node conserven la ubicació exacta quan cal.
- El broker experimental no va arribar a producció. La seva prova canària va atendre una sol·licitud, però després va fallar la prova d’aturada neta. LiteLLM es va mantenir al recorregut verificat per sol·licitud.
- Hermes i Aperture continuen en preparació. El disseny objectiu existeix, però falta la prova d’acceptació d’extrem a extrem.
Requisits previs: diversos hosts Linux amb GPU, controladors NVIDIA estables, un tailnet Tailscale, systemd, un miner operatiu, emmagatzematge de models i proves d’acceptació per a cada recorregut de model.
Temps i dificultat: avançat. Reserveu diversos dies per a l’inventari, la descàrrega dels models, les definicions de servei, les proves d’encaminament, els exercicis de fallada i les comprovacions de recuperació de la mineria per targeta.
Termes emprats a continuació: un tailnet és la xarxa privada formada per identitats i dispositius Tailscale. Un àlies de model és un nom estable de model que es mostra als clients. Un grup de models posa diversos desplegaments darrere d’un àlies. Un proxy de pool és un petit servei local que lloga una GPU, inicia el worker del model i retorna la targeta a la mineria.
Objectiu del disseny
La feina agèntica té moltes formes. Reparar un repositori requereix un model diferent del que convé per a un títol, una captura de pantalla, un embedding o una etiqueta d’intenció. Enviar cada torn al model més gran malgasta diners i capacitat local. Enviar cada torn al més petit provoca reintents i resultats febles.
Volíem un únic catàleg amb cinc franges de càrrega. La política havia de servir models allotjats i locals amb formats d’API coneguts. Les GPU locals havien de continuar sent productives entre les sol·licituds d’IA.
La flota també havia de permetre concurrència. Un host amb diverses targetes havia de servir diverses feines independents alhora. Una sol·licitud en una targeta no havia d’aturar la mineria a totes les targetes del xassís.
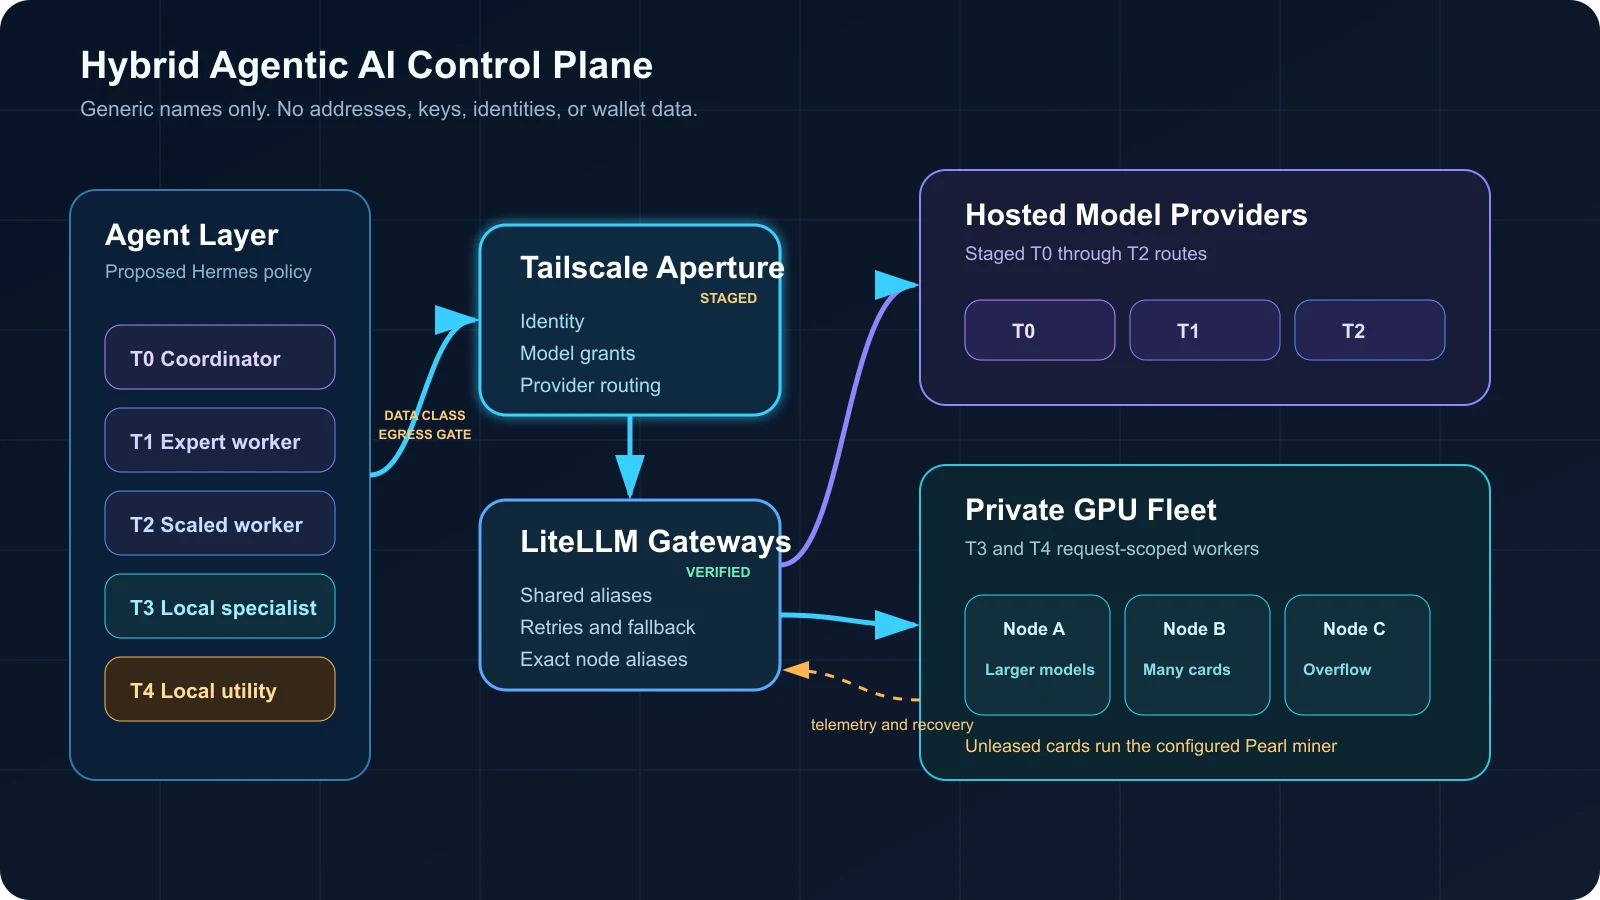
El camí de control proposat i el que és en preparació se situen per damunt del camí d’execució LiteLLM verificat per GPU
El diagrama utilitza noms genèrics de node. Omet adreces privades, identitats d’usuari, claus d’accés, dades de moneders i etiquetes dels hosts físics.
Què volen dir T0 a T4
Els noms dels nivells representen la nostra política d’encaminament. No són un estàndard del sector i no descriuen només la mida del model.
| Nivell | Funció principal | Destinació habitual | Comportament en cas de fallada |
|---|---|---|---|
| T0 | Coordinador per defecte i decisions més difícils | Model de raonament de frontera allotjat | Cadena de contingència allotjada ordenada |
| T1 | Agents workers d’alt valor | Pool allotjat de models d’alta capacitat | Reintent dins la cadena assignada |
| T2 | Pool general de workers | Models allotjats ràpids, amb escalament | Escalar les tasques difícils a T1 o T0 |
| T3 | Feina local privada substancial | Models locals de xat, codi, revisió i visió de 4B a 12B | Reintent en un node local apte i, després, fallada segura per a dades restringides |
| T4 | Feina local acotada i freqüent | Models locals d’encaminament, classificació, codi i embeddings de 0,6B a 3B | Reintent en una rèplica local o pas a T3 dins del mateix límit de dades |
Els nivells descriuen la tasca abans que el model. Una classificació breu i sensible a la seguretat encaixa a T4. Un pla llarg de repositori encaixa a T3 o superior. Una decisió arquitectònica difícil comença en un nivell superior, encara que el prompt sigui breu.
Aquesta divisió també canvia l’economia dels agents. Els workers T4 absorbeixen transformacions repetitives de baix risc. Els workers T3 mantenen el codi habitual i l’anàlisi dins del tailnet. T0 a T2 continuen disponibles per a la feina difícil i la recuperació de fallades.
Un filtre per classe de dades ha de precedir qualsevol fallback allotjat. Les tasques públiques, internes i restringides reben cadenes separades. Les tasques restringides es queden en local i fallen de manera segura. Un reintent que travessi el límit necessita entrades sanejades i l’aprovació explícita de l’usuari o del flux de treball. L’esborrat elimina credencials, secrets del repositori, sortides privades de les eines i contingut sensible recuperat abans de qualsevol crida allotjada.
Com Hermes gestionarà la política de les tasques
Hermes és la capa d’agents proposada. La política objectiu assigna una classe de model, executa eines, delega feina i recorre cadenes de contingència explícites. Hermes documenta recorreguts separats per al model principal, les feines auxiliars, els agents delegats i els fallbacks específics de tasca. També admet endpoints personalitzats compatibles amb OpenAI mitjançant una URL base. Consulteu la guia de configuració Hermes i la guia de proveïdors de fallback .
La nostra política associa les feines Hermes a àlies estables en lloc de servidors físics. Per exemple:
t3-smart
t3-code
t3-review
t3-vision
t4-code
t4-classify
t4-router
t4-embedding
L’àlies expressa la intenció. Hermes no ha de saber quina GPU és lliure, quin node té una targeta més gran ni quina rèplica ha fallat la comprovació de salut. Les capes inferiors prenen aquestes decisions.
Algunes feines encara necessiten una ubicació determinista. Un ID de model prefixat amb un node envia un diagnòstic d’operador o un benchmark a un sistema seleccionat. Grants Aperture separats haurien de restringir aquests àlies als operadors. El trànsit normal dels agents utilitza àlies de nivell compartits.
L’accés als models no protegeix les eines dels agents. El desplegament Hermes necessita llistes de permís d’eines amb privilegis mínims, espais de treball aïllats, credencials d’abast limitat, controls de sortida de xarxa i tractament de la injecció de prompts. Els workers delegats no haurien d’heretar més accés del que exigeix la feina assignada.
Aperture és el límit d’identitat en preparació
Tailscale connecta la passarel·la configurada i els hosts d’inferència sense publicar cada servei a Internet. Aperture s’està preparant com a límit per a usuaris i encaminador de models. Aquest recorregut encara necessita una prova d’acceptació d’extrem a extrem. Tailscale documenta l’accés xifrat dels clients pel tailnet i el reenviament dels proveïdors per TLS a Com funciona Aperture .
Aperture també separa l’abast de l’autorització. Els seus grants deneguen l’accés per defecte. Un cop al gateway, un usuari o dispositiu etiquetat necessita un grant del model corresponent. La guia de grants d’Aperture explica el model additiu i les fonts d’identitat.
Abans del desplegament, la configuració d’Aperture en preparació hauria de seguir quatre regles:
- Una sola identitat amb nom té el rol d’administrador. L’accés general als models no concedeix administració.
- Els proveïdors enumeren IDs literals de model. Aperture no infereix models d’un servei upstream.
- Les URL dels proveïdors apunten a adreces del tailnet. Els noms i adreces dels nodes privats queden fora de l’article i dels exemples públics de configuració.
- Els secrets es queden en fitxers propietat del servei. Abans del desplegament, apliqueu permisos només per al propietari, comptes de servei restringits, rotació i esborrat dels registres. La sortida de diagnòstic no ha de mostrar mai claus LiteLLM, adreces tailnet, tokens de subscripció ni dades de moneders.
Aperture afegeix el camí de la sol·licitud entrant a la URL base de cada proveïdor. La seva
referència de configuració
adverteix de no posar un sufix /v1 duplicat a l’arrel del proveïdor. Aquest detall va generar prou risc d’integració per justificar una comprovació explícita.
La visió està preparada per passar pel format OpenAI Chat Completions amb contingut d’imatge. Els embeddings utilitzen directament l’endpoint LiteLLM privat perquè la matriu actual de proveïdors autoallotjats d’Aperture documenta formats de xat, mentre que el nostre recorregut d’embeddings depèn d’endpoints LiteLLM i llama.cpp fora del selector de xat. Consulteu la referència de proveïdors i clients compatibles .
El recorregut directe d’embeddings necessita el seu propi límit d’autorització. L’autenticació LiteLLM, els grants Tailscale restrictius, la vinculació del servei a la interfície del tailnet i les regles del tallafoc de l’host haurien de limitar l’accés a identitats o etiquetes de servei aprovades. Una adreça privada, per si sola, no és una política d’autorització.
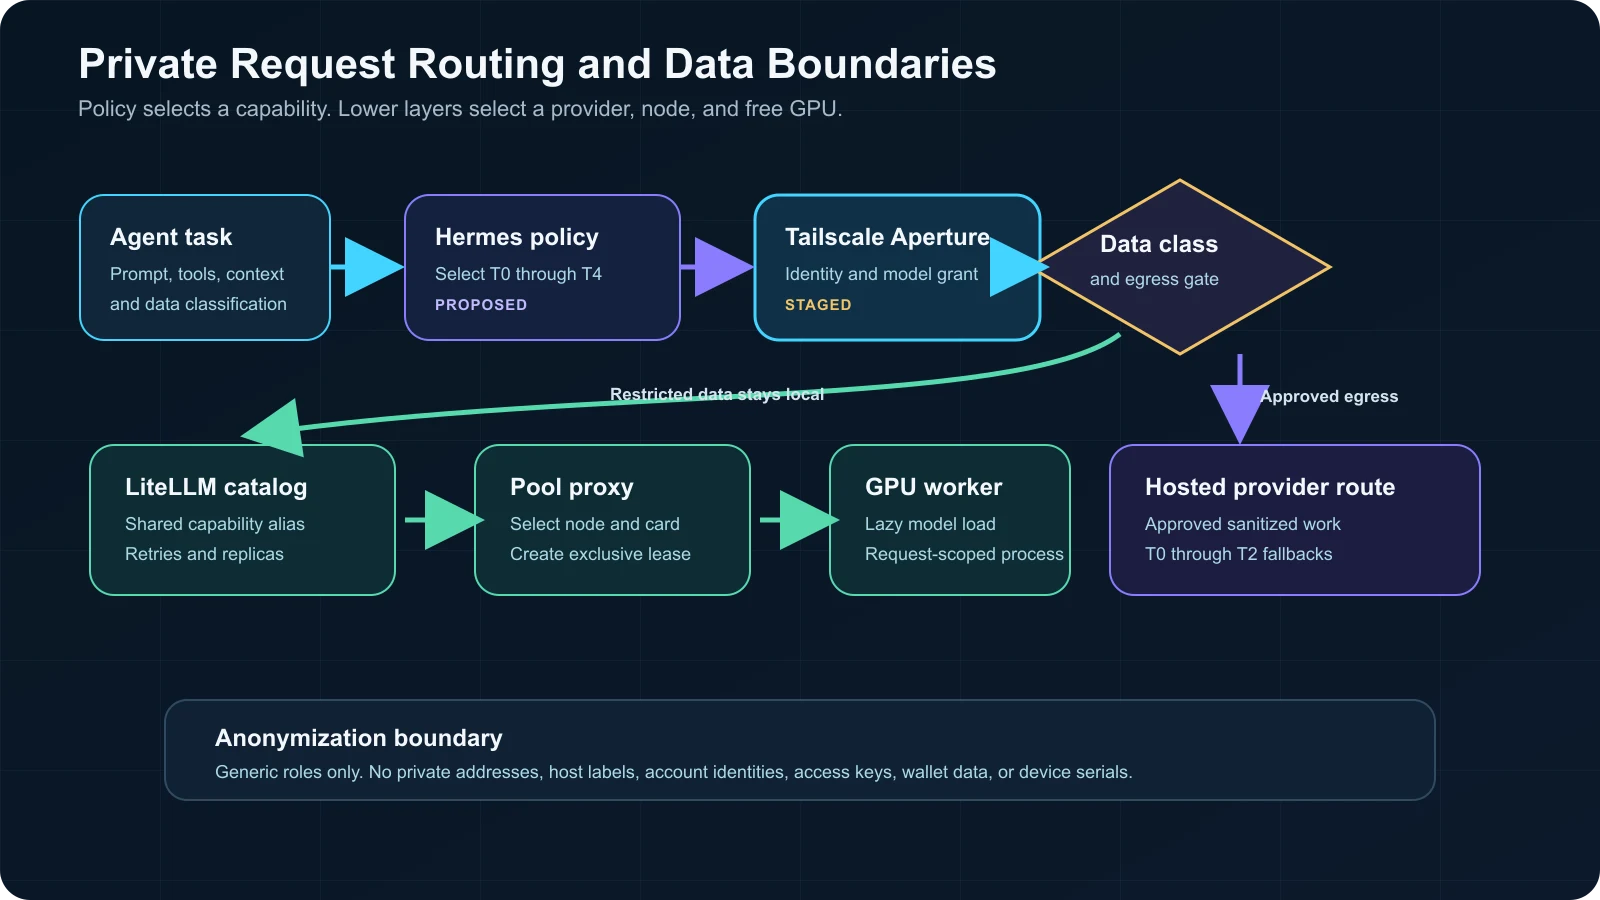
La identitat, els grants i la classificació de dades decideixen si una sol·licitud surt de la flota privada
LiteLLM presenta un únic catàleg
Cada host d’inferència executa una passarel·la LiteLLM. Totes les passarel·les exposen el mateix catàleg lògic de models, fins i tot si un model és en un altre node. El client manté una sola forma d’API i un únic conjunt d’àlies.
LiteLLM agrupa diversos desplegaments sota un nom de model. El router selecciona un desplegament apte i aplica reintents, temps d’espera, períodes de repòs o fallbacks. La documentació actual d’encaminament LiteLLM cobreix noms de model compartits, estratègies d’encaminament i comportament dels reintents.
El catàleg té dos estils d’adreça:
| Estil d’adreça | Exemple | Ús |
|---|---|---|
| Àlies compartit | t4-classify | Distribuir feina normal entre nodes aptes |
| Àlies de node | node-b/qwen-small | Executar diagnòstics o conservar la ubicació |
Els àlies compartits permeten escalar horitzontalment sense canviar Hermes. Afegir una rèplica apta amplia el grup de models. Treure una rèplica amb problemes redueix el grup.
Mantenim la lògica del cicle de vida de GPU per sota de LiteLLM. La passarel·la continua activa perquè la seva memòria no reserva memòria GPU. Un proxy de pool local rep la sol·licitud del model seleccionat, lloga una targeta, inicia el worker i l’atura després de la resposta.
Catàleg local de models
La flota prioritza models de 12B paràmetres o menys. Aquest límit concorda amb la memòria de les targetes i deixa espai per al context i els buffers d’execució.
Notació dels models: B vol dir milers de milions de paràmetres. K vol dir milers de tokens de context configurats. La quantització desa els pesos del model amb menys precisió numèrica per reduir la memòria necessària. La memòria cau KV conserva l’estat d’atenció del context actiu i creix amb la longitud del prompt. E4B és l’etiqueta de mida de Google per a la variant Gemma 4 més petita.
| Ruta de nivell | Classe de model | Context configurat | Tasca principal | Ubicació |
|---|---|---|---|---|
| T3 intel·ligent | Qwen3.5 9B, quantitzat | 64K | Planificació local difícil i feina general d’agent | Nodes GPU amb més memòria |
| T3 codi | Granite 4.2 8B, quantitzat | 64K | Feina en repositoris, eines, terminal i sortida estructurada | Nodes GPU amb més memòria |
| T3 revisió | Gemma 4 12B, quantitzat | 32K | Revisió independent i raonament alternatiu | Nodes GPU amb més memòria |
| T3 general i visió | Qwen3.5 4B, quantitzat | 32K | Feina general a escala i comprensió d’imatges | Totes les GPU compatibles |
| T3 revisió alternativa | Gemma 4 E4B, quantitzat | 8K | Recorregut de revisió divers | Totes les GPU compatibles |
| T4 codi | Granite 4.2 3B, quantitzat | 16K | Edicions petites, crides d’eines i sortida estructurada | Totes les GPU compatibles |
| T4 classificar | Qwen3.5 2B, quantitzat | 16K | Classificació, extracció i reescriptura | Totes les GPU compatibles |
| T4 encaminador | Qwen3.5 0.8B, quantització d’alta precisió | 16K | Intencions, etiquetes, títols i transformacions breus | Totes les GPU compatibles |
| T4 embeddings | Qwen3 Embedding 0.6B, quantitzat | 32K | Memòria d’agents, RAG, recuperació de codi i agrupament | Totes les GPU compatibles |
Aquests valors de context són opcions de desplegament, no límits anunciats dels models. Una finestra anunciada més gran també consumeix memòria cau KV i memòria d’execució. Hem triat valors més baixos per a un servei estable amb una sola targeta.
Qwen descriu Qwen3.5 com una família multimodal i publica variants denses, de petites a grans, a la col·lecció Qwen3.5 . IBM publica resultats de codificació agèntica i context llarg per a Granite 4.2 8B . Google indica que Gemma 4 admet entrades multimodals, crides de funció i una finestra anunciada més gran.
El recorregut d’embeddings utilitza un model separat en lloc de demanar vectors a un model de xat. La fitxa del model Qwen3 Embedding 0.6B indica longitud de seqüència de 32K, recuperació multilingüe i de codi, i dimensions de sortida de fins a 1.024.
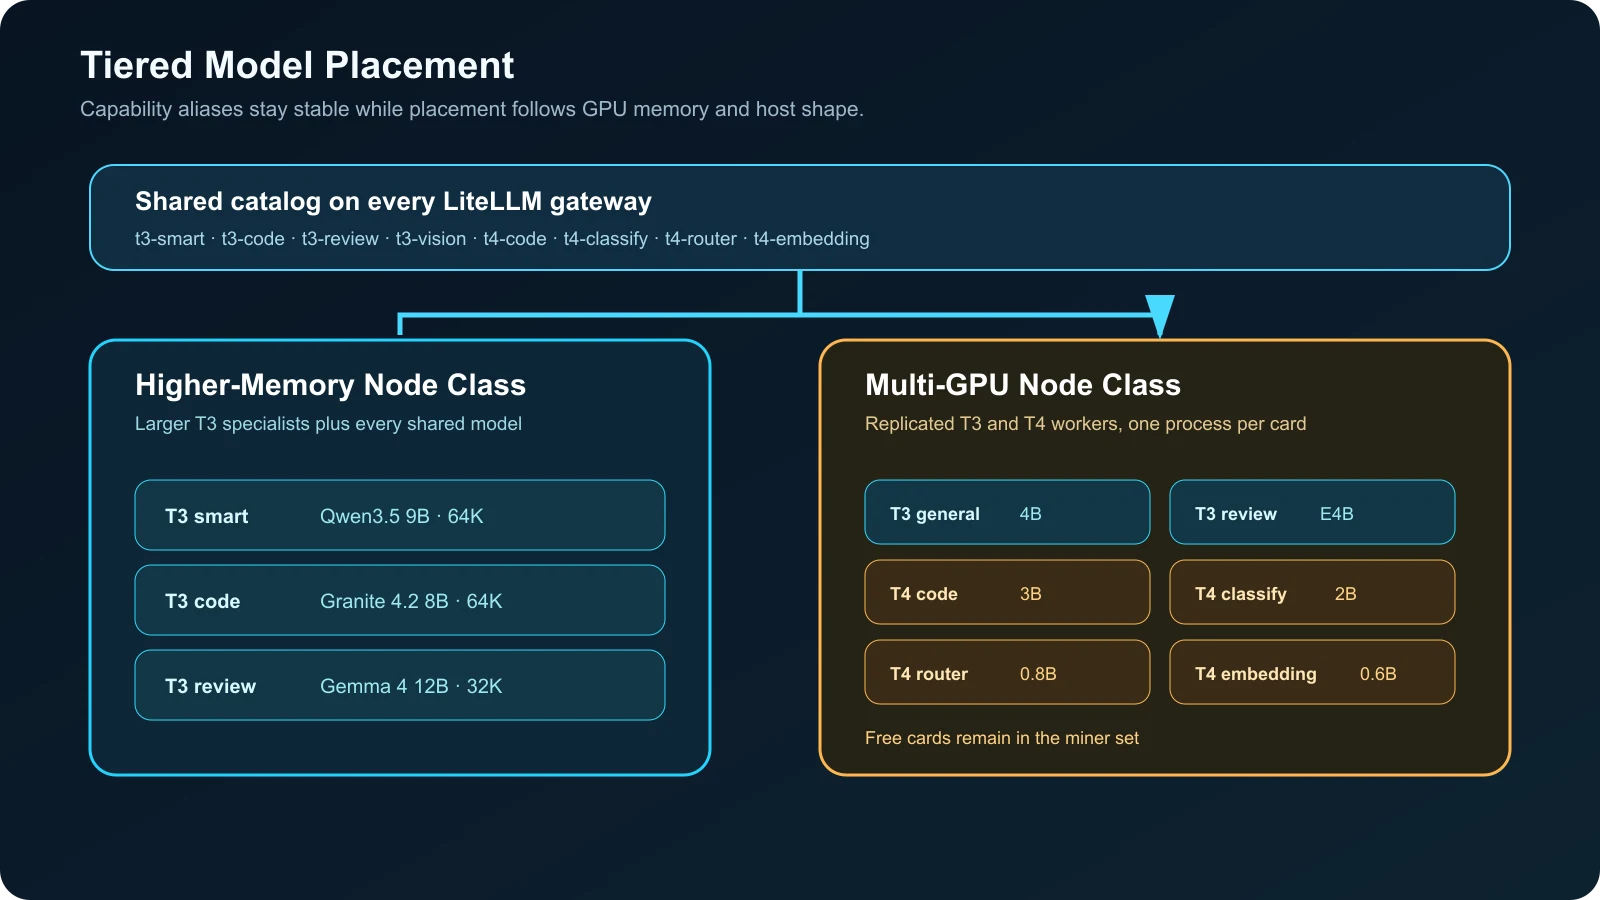
Els especialistes més grans es queden a les targetes amb més memòria, mentre que els més petits es repliquen per la flota
Per què llama.cpp funciona en producció
llama.cpp encaixa amb el model de recursos. Un worker estàtic correspon a una GPU, un fitxer de model, un context configurat i un lease. La separació de processos facilita l’auditoria de l’inici, l’aturada, la visibilitat GPU i els registres.
El seu servidor exposa xat, respostes i embeddings compatibles amb OpenAI. També admet descodificació paral·lela i agrupament continu. La documentació actual del servidor qualifica de experimental el suport multimodal. Aquestes funcions apareixen a la documentació del servidor llama.cpp .
Ollama continua disponible com a camí de compatibilitat en un node més gran. Ollama admet càrregues simultànies de models si la memòria és suficient i descàrrega immediata amb keep_alive: 0, tal com documenta la
PMF d’Ollama
. No vam triar Ollama per al recorregut de producció per targeta perquè els workers estàtics llama.cpp ens donen un control més precís de la ubicació i l’aturada.
També vam revisar Strata. Strata apunta a un gran model Qwen de barreja d’experts repartit entre memòria GPU, RAM del sistema i emmagatzematge. Els valors predefinits publicats comencen amb 32 GB de memòria combinada, mentre que el mode de poca RAM intercanvia velocitat per menys capacitat. Consulteu el repositori Strata . Strata encaixa amb un objectiu diferent: un model híbrid més gran en una o diverses targetes. La nostra flota prioritza molts workers independents per sota de 12B.
Càrrega sota demanda per GPU
La càrrega sota demanda s’aplica a cada worker de model. Entre sol·licituds, el sistema només manté actius les passarel·les, els proxies de pool, els watchdogs i el miner.
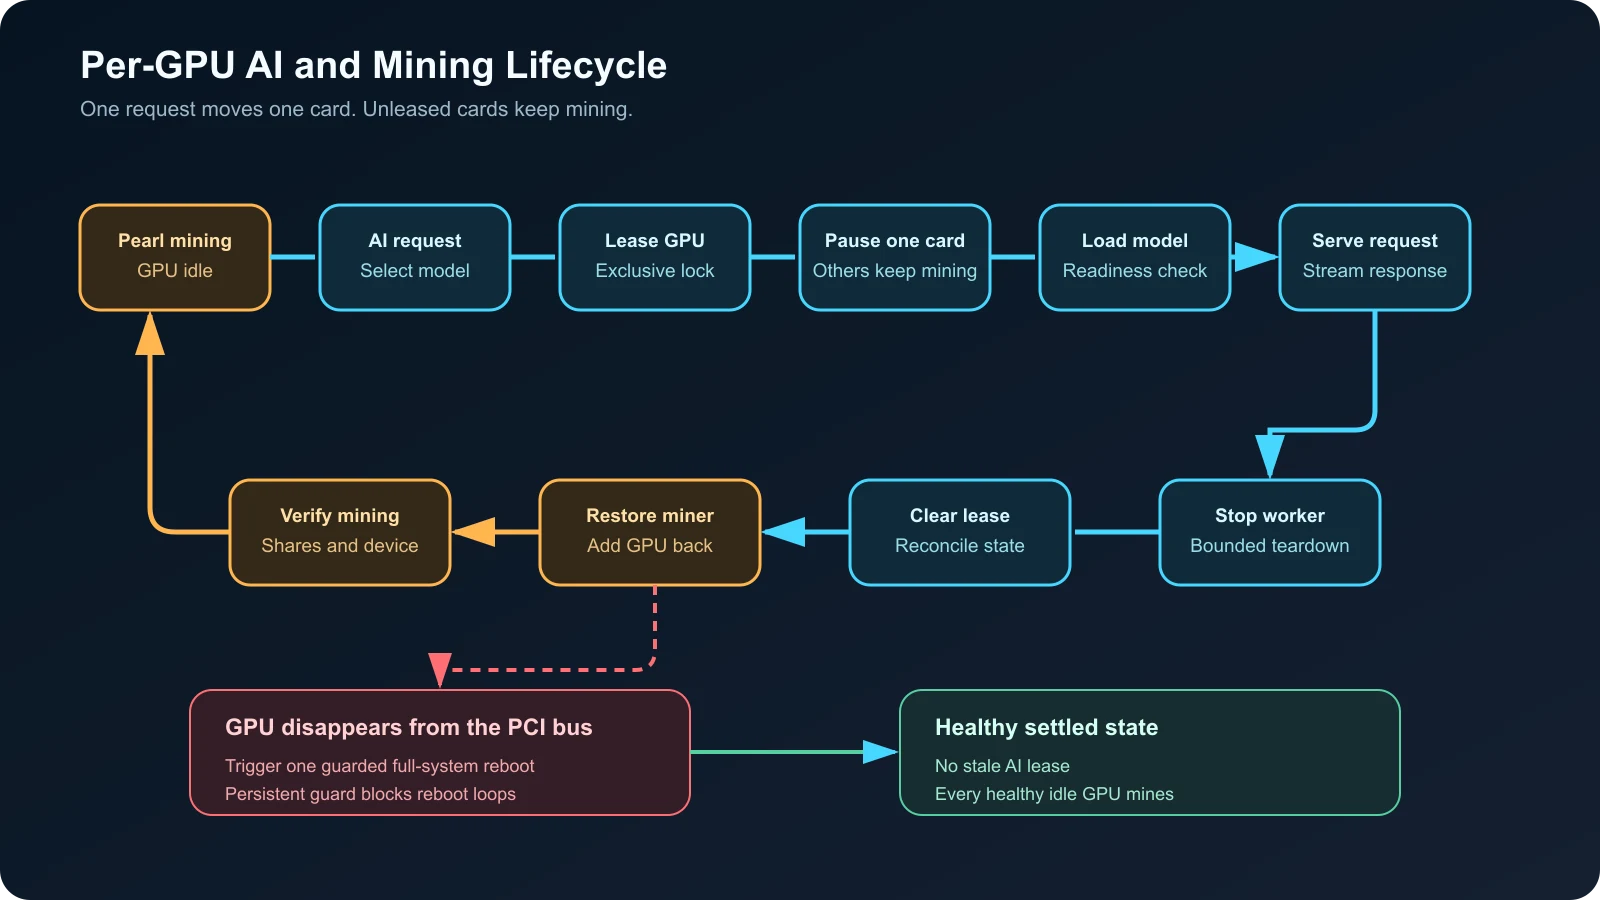
Només la targeta llogada deixa el miner i hi torna quan acaba el procés del model
El cicle de vida d’una sol·licitud segueix aquests passos:
- LiteLLM selecciona un desplegament. La sol·licitud arriba al proxy de pool de la classe de model seleccionada.
- El pool obté un lease. Un bloqueig impedeix que dos workers exclusius agafin la mateixa targeta.
- El miner es reinicia sense una GPU. Cada targeta no llogada continua a l’ordre Pearl.
- llama.cpp s’inicia al dispositiu llogat. Les comprovacions de disponibilitat acaben abans que el proxy reenviï la sol·licitud.
- El worker serveix la resposta. Les sol·licituds concurrents inicien workers en altres targetes lliures.
- El worker surt. El pool elimina el lease després que el procés s’aturi.
- El miner es reinicia amb la GPU alliberada. Les comprovacions de salut confirmen que la targeta ha tornat a la mineria.
Això és diferent de canviar l’host sencer de manera global. Un xassís amb diverses targetes serveix diversos models mentre les altres targetes continuen minant. Quan la flota està inactiva, totes les GPU saludables tornen a Pearl.
El llibre blanc de Pearl descriu el seu sistema de prova mitjançant càlcul matricial. La nostra arquitectura no depèn d’una previsió de rendibilitat ni d’una afirmació de retorn econòmic. La mineria és la càrrega de treball configurada quan el sistema està inactiu.
La gestió de fallades importa més que l’inici
L’inici del model és només la meitat del cicle de vida. Les aturades forçades, les GPU desaparegudes, les sol·licituds interrompudes, els leases obsolets i els reinicis del miner necessiten un tractament explícit.
El nostre watchdog compara el conjunt de GPU configurat amb la llista activa de dispositius NVIDIA. La confirmació d’una GPU absent desencadena un únic reinici complet del sistema, amb proteccions. Un desencadenant de producció segur hauria d’exigir comprovacions fallides repetides, un període d’espera, drenatge de tasques actives, un comptador persistent de reinicis i una alerta remota. Una recuperació fallida hauria d’aturar l’automatització i requerir intervenció manual.
El mateix watchdog reconcilia leases obsolets. Si cap worker no té el lease, la reconciliació elimina el registre obsolet i retorna la GPU al miner. Aquest recorregut de recuperació va ser important durant el canary del broker.
| Fallada | Resposta |
|---|---|
| El model falla la comprovació de disponibilitat | Aturar el worker, alliberar el lease, restaurar la mineria i retornar un error |
| La sol·licitud acaba inesperadament | Limitar el temps de neteja, acabar l’arbre de processos del worker i reconciliar el lease |
| La GPU desapareix | Confirmar absències repetides, drenar feina activa, fer un reinici protegit, alertar i després verificar tot el conjunt de GPU configurat |
| El miner omet una targeta inactiva | Reconstruir la llista de dispositius a partir dels leases actius i reiniciar el miner |
| Un desplegament LiteLLM falla | Reintentar amb una altra rèplica del mateix grup de models i després seguir la política de fallback |
| Un grant Aperture bloqueja una ruta | Corregir la identitat o el grant del model, mai esquivar la política de la passarel·la |
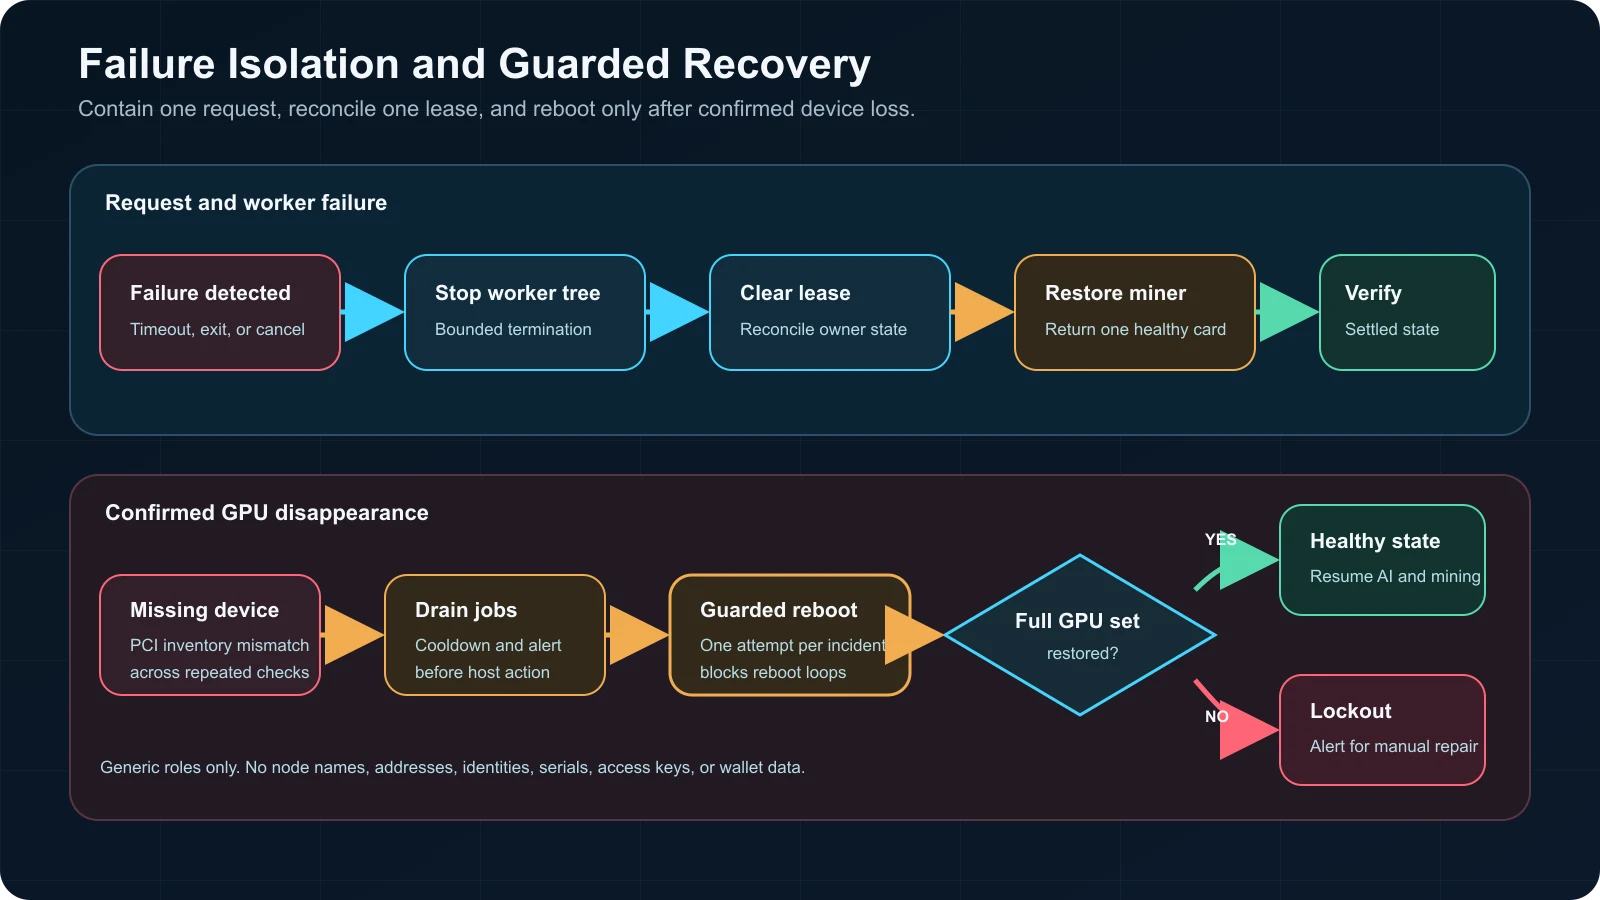
Les fallades habituals alliberen un lease, mentre que la pèrdua confirmada del dispositiu activa la ruta protegida de recuperació de l’host
Què va passar amb l’intermediari experimental
El broker independent del backend vol oferir una única interfície compatible amb OpenAI per a Ollama, vLLM, llama.cpp i Strata. Inclou gestió del cicle de vida per model, descàrrega en repòs i ubicació de GPU.
Vam provar la versió 0.6.0 del broker al commit c12b65 el 21 d’octubre de 2026. La seva suite local va informar de 1.101 proves superades i 2 omeses, amb Ruff net. El canary va carregar un model sota demanda i va atendre una sol·licitud de xat correctament. Les altres GPU van continuar minant durant la sol·licitud.
L’aturada va revelar un problema crític del cicle de vida. Després de carregar un model, el broker continuava bloquejat en el procés d’aturada fins que systemd matava l’arbre de processos. L’aturada forçada va deixar un lease GPU obsolet fins que la reconciliació va restaurar el miner. També vam trobar una diferència entre l’opció documentada de GPU obligatòria i l’aplicació efectiva a l’adaptador de producció.
Hem desactivat el broker al recorregut de producció. LiteLLM ara encamina pel proxy de pool per sol·licitud. El broker continuarà sent experimental fins que l’aturada limitada dels processos fill, la terminació dels grups de processos, les comprovacions d’admissió de GPU obligatòria i la neteja dels leases obsolets superin les proves d’integració.
Aquest resultat aporta una lliçó d’enginyeria útil. Un broker demostra poca cosa quan inicia un model una vegada. La preparació per a producció depèn d’una aturada neta, recuperació limitada, admissió exclusiva de dispositius i exercicis de fallada repetibles.
Verificacions fetes
La prova de desplegament va cobrir més que una resposta de model:
- Cada model de xat compartit va completar el cicle de càrrega, resposta, sortida i recuperació Pearl en almenys un host apte.
- La visió va acceptar entrada d’imatge pel recorregut de xat.
- Els embeddings van retornar la mida de vector configurada pel camí LiteLLM privat.
- Diversos models van funcionar alhora en targetes separades.
- Les targetes no llogades van continuar al miner durant sol·licituds d’IA concurrents.
- Els àlies compartits van encaminar entre nodes aptes.
- Els àlies prefixats amb el node van conservar una ubicació determinista.
- Cada passarel·la LiteLLM va enumerar el mateix catàleg lògic.
- Una GPU desapareguda es va recuperar després d’un reinici complet de l’host. Ara el watchdog té un bloqueig persistent de bucle.
- Una fallada d’aturada del broker es va recuperar mitjançant la reconciliació del lease.
- L’estat final estable no tenia leases d’IA i totes les GPU saludables havien tornat al conjunt del miner.
Les comprovacions de salut i les llistes de models no es van considerar proves de càrrega del model. Una prova d’acceptació útil envia una sol·licitud real, comprova la resposta, confirma la GPU seleccionada, observa l’aturada i verifica la recuperació de la mineria.
Resolució de problemes de la flota
| Símptoma | Primera comprovació |
|---|---|
| El model apareix però fallen les sol·licituds | ID del model upstream, format API, capçalera d’autenticació i URL base del proveïdor |
| Aperture retorna 405 | L’arrel del proveïdor no té un sufix /v1 duplicat |
| El node equivocat atén la sol·licitud | Àlies compartit o àlies prefixat amb el node |
| Dos workers volen la mateixa targeta | Bloqueig del lease, estat del lease obsolet i lògica d’admissió GPU |
| La mineria s’atura a totes les targetes | El codi de reinici del miner crea la llista de dispositius a partir dels leases actius |
| La GPU no torna a minar | Arbre de processos del worker, reconciliació del lease i llista de dispositius del miner |
| La càrrega en fred és lenta | Mida del model, velocitat d’emmagatzematge, amplada de l’enllaç PCIe i pressió de CPU de l’host |
| Fallen els prompts llargs | Context configurat, marge de memòria cau KV i reserva de sortida |
| Falta la ruta d’embeddings a Aperture | Utilitzeu la ruta LiteLLM autenticada, restringida per la identitat Tailscale i la política del tallafoc de l’host |
| L’aturada del broker queda bloquejada | Desactiveu la ruta del broker i torneu el trànsit al proxy de pool verificat |
Regles de disseny que convé mantenir
- Encamineu segons el propòsit de la tasca. La mida del model no defineix tota sola el nivell.
- Manteniu la política per sobre de la ubicació. Hermes tria un àlies de capacitat. LiteLLM tria un desplegament. El pool tria una GPU.
- Tracteu cada GPU com un lease separat. Canviar l’host sencer malgasta les targetes disponibles.
- Descarregueu tots els models inactius. Les passarel·les actives no necessiten workers GPU actius.
- Conserveu una ruta restringida d’ubicació exacta. Els àlies de node només per a operadors fan que els diagnòstics siguin reproduïbles.
- Proveu primer l’aturada. La recuperació del miner i la neteja dels leases formen part de les proves d’acceptació.
- Separeu xat, visió i embeddings. Una passarel·la no implica una sola ruta de protocol.
- Manteniu els detalls privats fora dels diagrames. Publiqueu funcions i fluxos, no adreces, claus, identitats ni dades de moneders.
- Protegiu la lògica de reinici. Exigiu absències repetides, període d’espera, comptador persistent, alerta i intervenció manual després d’una recuperació fallida.
- Manteniu una ruta alternativa experimental. Una fallada del broker no hauria d’arrossegar també la ruta verificada.
Passos següents
La següent fase és avaluar les càrregues. Cada nivell necessita un conjunt fix de tasques, criteris d’acceptació, registres de latència, ocupació GPU, temps d’interrupció de la mineria i percentatges d’escalament. Aquestes mesures mostraran quines tasques T2 encaixen a T3 i quines tasques T3 caben a T4.
També volem executar la primera prova d’acceptació d’Hermes a través d’Aperture i LiteLLM, i tornar a provar el broker després de corregir els recorreguts d’aturada i admissió GPU. La generació d’imatges necessita el seu propi adaptador compatible amb OpenAI i amb càrrega sota demanda abans d’afegir-la al mateix catàleg d’encaminament.
Per dimensionar models, llegiu la guia de context dels models locals d’IA i GPU . Per als límits de privadesa, llegiu Privadesa i seguretat de la IA local . Per a la configuració i els riscos del miner, consulteu la guia de mineria Pearl en lloc de considerar la mineria en períodes inactius com a benefici garantit.
Related Posts