Són suficients 16GB de VRAM per treballar seriosament amb LLM locals?
Table of Contents
16GB de memòria GPU dedicada permeten treballar seriosament amb LLM locals quan el model, el context i el runtime encaixen. Carregar els pesos només demostra el primer requisit. Una configuració útil també necessita prou memòria per a la conversa activa i prou velocitat per acabar la tasca.
Fes servir Qwen3.8 27B com a exemple pràctic per pressupostar un flux de treball de codi o documents per a un sol usuari. Comença amb el context que necessita la tasca i després tria pesos i ajustos del runtime que encaixin amb la memòria restant. Les especificacions del maquinari i les fonts del model es van revisar el 7 d’octubre de 2026.
Idees principals
- Reserva memòria per al context abans d’escollir una quantització.
- Mesura el processament del prompt per separat de la velocitat de sortida.
- Desactiva el suport de visió que no facis servir i prova una memòria cau KV de 8 bits.
- Compara la GPU, el backend, el fitxer del model i la llargada del prompt exactes.
- Calcula l’estalvi de propietat segons la teva càrrega de treball i la factura del proveïdor.
Per a l’exercici de pressupost, necessites el registre de memòria del runtime, el nom exacte del fitxer del model i una tasca representativa. Reserva uns 20 minuts per configurar i registrar resultats, a més del temps d’inferència. La dificultat és intermèdia.
Ajusta la memòria a la feina
16GB encaixen amb una càrrega els pesos, el context actiu i les assignacions temporals de la qual es mantenen dins de la memòria GPU disponible. El context requerit depèn de la tasca. Un resum curt i un agent de codi que llegeix desenes de fitxers necessiten pressupostos diferents.
| Càrrega de treball | Primera pregunta de dimensionament |
|---|---|
| Xat curt o redacció | El model compleix el teu objectiu de qualitat? |
| Anàlisi de documents | El text font i la resposta hi caben junts? |
| Agent de codi | Quant context consumeixen els fitxers i els resultats de les eines? |
| Peticions concurrents | Quanta memòria cau necessita cada sessió activa? |
Una finestra configurada és diferent d’una finestra ocupada. Un benchmark amb límit de 64K i prompt curt no mesura la generació després de 55K tokens de conversa. Prova prop de la durada esperada abans d’escollir maquinari.
Per què hi cap el model
La quantització desa els pesos amb menys bits. La taula de fitxers Qwen3.8 27B de Bartowski indica 17.44 GB per a Q4_K_M, per sobre dels aproximadament 17.18 mil milions de bytes d’un dispositiu de 16 GiB abans de la memòria del runtime.
La fitxa del model GSQ-RCO d’ISTA-DASLab indica 11.8 GB per a IQ3_S. El mètode assigna precisions diferents a tensors diferents dins d’un pressupost de mida. La versió MTP opcional afegeix uns 0.35 GB i el projector de visió uns 0.9 GB.
| Benchmark publicat | Puntuació BF16 / IQ3_S |
|---|---|
| AIME25 | 100.00 / 100.00 |
| LiveCodeBench v6 | 85.71 / 85.71 |
| GPQA-Diamond | 89.90 / 89.39 |
El laboratori anomena aquest punt de funcionament “sense pèrdua de tasca”. Aquests resultats admeten una comparació limitada. No demostren respostes idèntiques, recuperació igual en context llarg ni fiabilitat igual en les teves tasques de codi. Prova el model comprimit amb els teus criteris d’acceptació.
Compta la memòria cau
La memòria cau KV desa les claus i els valors d’atenció dels tokens ja processats. El prompt, la sortida de les eines i les respostes generades consumeixen context. Alguns runtimes assignen la capacitat de memòria cau en iniciar-se, de manera que la memòria mostrada no ha de créixer amb cada missatge.
La configuració de Qwen especifica 64 capes, atenció completa cada quarta capa, quatre caps KV i una dimensió de cap de 256. Per a les 16 capes d’atenció completa, el cost FP16 calculat és:
16 layers × 4 KV heads × 256 elements × 2 (K and V) × 2 bytes
= 65,536 bytes per token
= 64 KiB per token
El càlcul exclou l’estat recurrent, l’alineació, els buffers temporals i les assignacions de descodificació especulativa. Altres arquitectures necessiten càlculs diferents.
| Tokens ocupats | Memòria cau FP16 d’atenció completa |
|---|---|
| 32,768 | 2 GiB |
| 65,536 | 4 GiB |
| 131,072 | 8 GiB |
| 262,144 | 16 GiB |
Aquí KiB i GiB fan servir potències de 1024. Les mides de baixada dels models fan servir GB decimals. Barrejar unitats distorsiona el pressupost restant.
Pressuposta el context disponible
Dos ajustos alliberen memòria per a sessions de text llargues: eliminar un projector de visió no utilitzat i reduir la precisió de la memòria cau. Calcula’n l’efecte contra el model carregat i les assignacions del runtime.
Fes servir aquest exemple, amb cada assignació expressada en GB decimals. La reserva d'1.0 GB és una assumpció de planificació, no un valor predeterminat universal del runtime.
| Assignació | Visió activada / visió desactivada |
|---|---|
| Capacitat física de 16 GiB | 17.180 / 17.180 GB |
| Pesos del model | 11.800 / 11.800 GB |
| Cap MTP opcional | 0.350 / 0.350 GB |
| Estimació del projector de visió | 0.930 / 0 GB |
| Altres assignacions assumides | 1.000 / 1.000 GB |
| Disponible per a la memòria cau creixent | 3.100 / 4.030 GB |
A 65,536 bytes per token, 3.100 GB contenen uns 47,300 tokens. Amb la visió desactivada, l’emmagatzematge ideal de 8 bits faria servir 32,768 bytes per token i contindria uns 123,000 tokens.
L’emmagatzematge q8_0 real inclou escales de bloc. A 34 bytes per 32 valors, aquest exemple necessita uns 34,816 bytes per token i redueix l’estimació a aproximadament 115,700. Altres assignacions la redueixen més. Per tant, uns 110K són un resultat de planificació plausible sota aquestes assumpcions, no un ajust garantit.
El context restant ha de cobrir l’entrada i la sortida. Amb una finestra de 65,536 tokens, un prompt inicial il·lustratiu de 30,000 tokens i una reserva de sortida de 8,192 deixen 27,344 tokens per als fitxers, els resultats de les eines i la conversa. El pressupost inicial és un exemple. Mesura les teves eines i instruccions.
Ajustos que val la pena provar
La documentació del servidor llama.cpp documenta tipus separats de memòria cau de claus i valors, càrrega automàtica del projector i ranures paral·leles. En una càrrega de text, prova la visió desactivada, q8_0 per als dos tipus de memòria cau i una ranura. Comença amb un context moderat.
Registra les assignacions resultants abans d’augmentar el context. La quantització de la memòria cau necessita suport de l’arquitectura i el backend triats. Prova la qualitat de les respostes després de canviar la precisió. Conserva una configuració funcional per comparar.
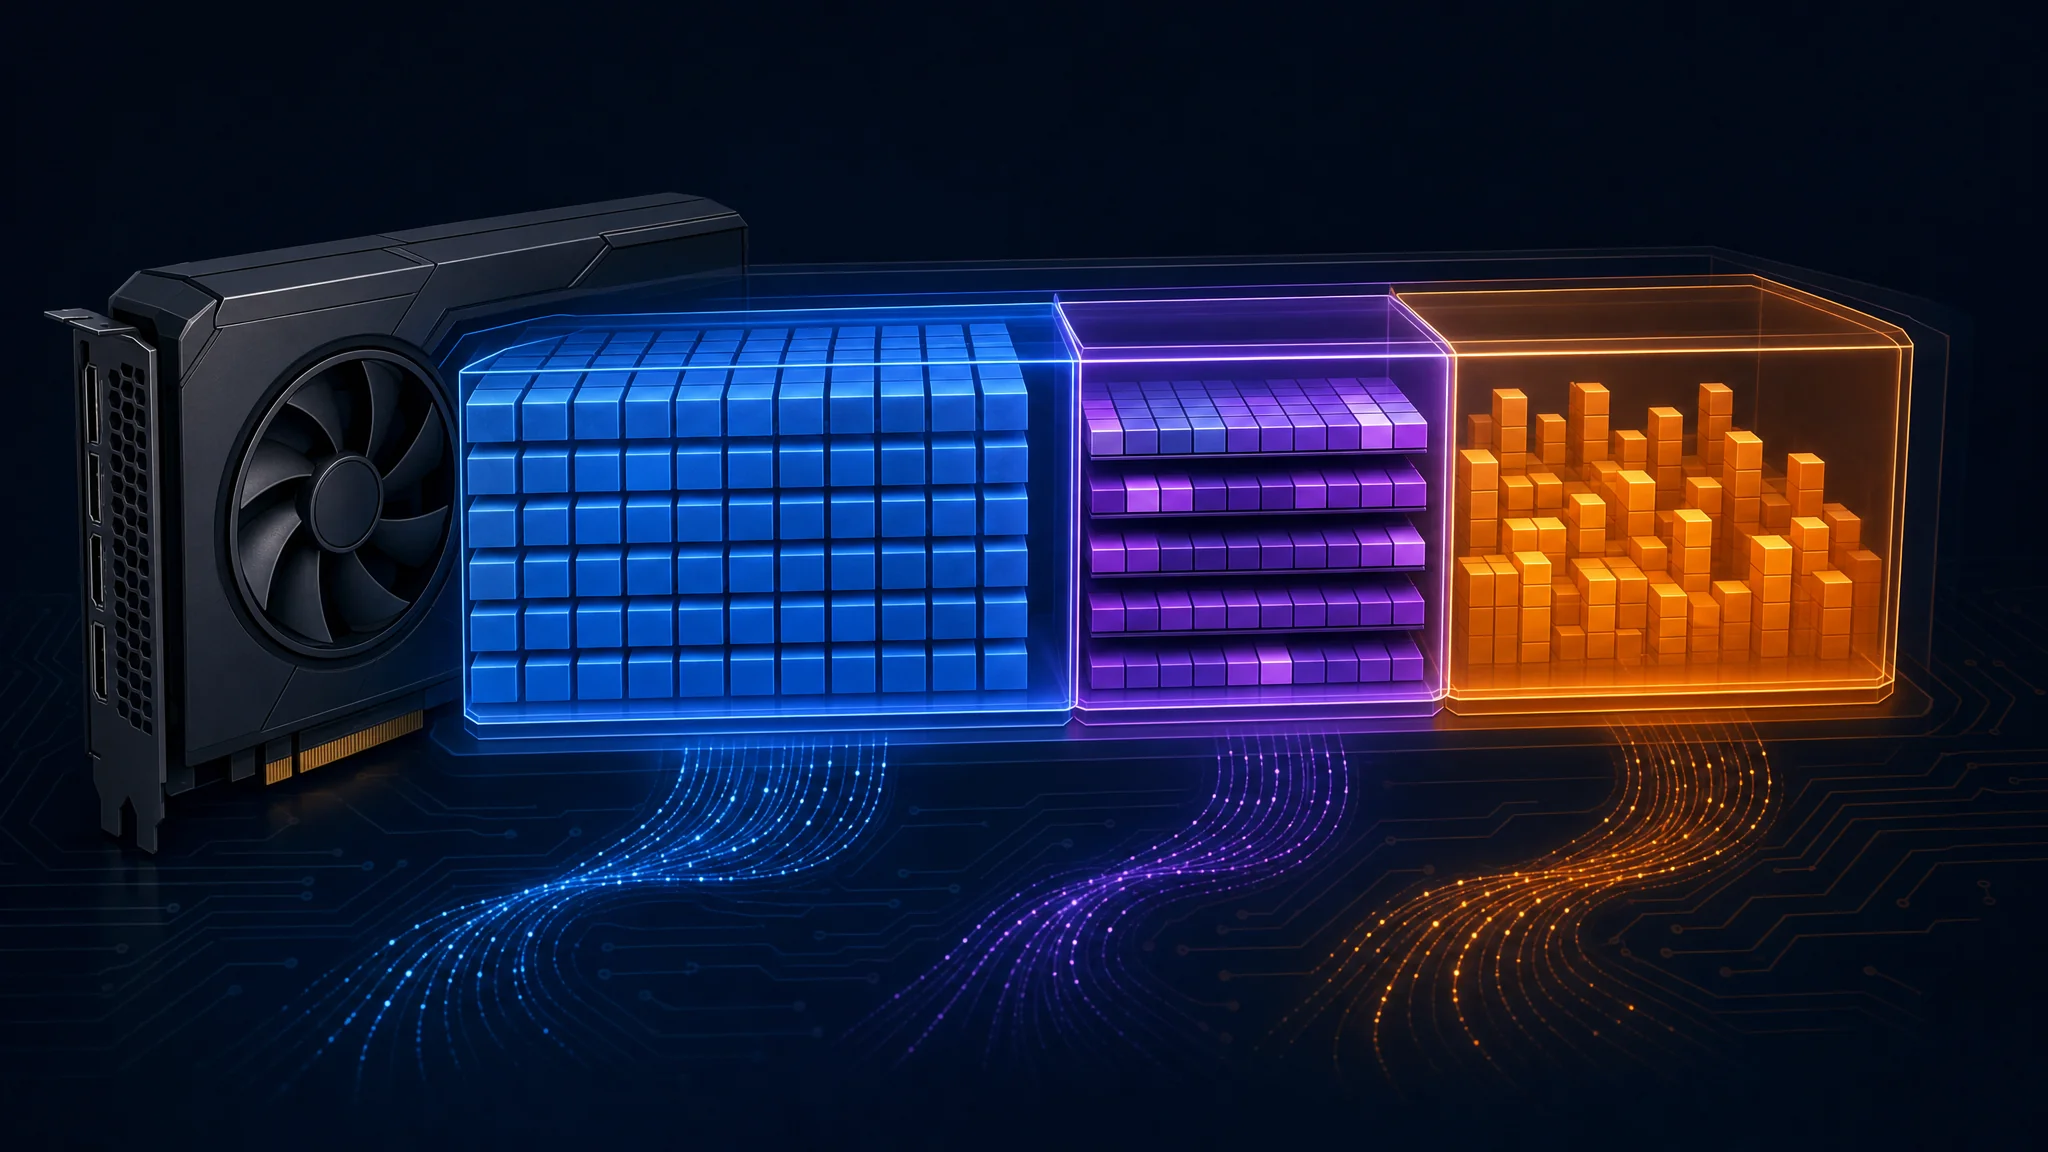
El blau representa els pesos, el lila la memòria cau del context i el taronja les assignacions del runtime. Les mides són il·lustratives
Per què difereixen les velocitats
Una etiqueta de 16GB descriu la capacitat. El rendiment també depèn de l’amplada de banda de memòria, els kernels de càlcul, el context actiu, l’offload, el batching i la descodificació especulativa.
| Causa | Què cal revisar |
|---|---|
| Offload a CPU o RAM | Posició de les capes carregades i ubicació de la memòria cau |
| Context llarg | Tokens ocupats durant la mesura |
| Diferències de backend | Commit del runtime, controlador i camí del kernel |
| Descodificació especulativa | Esborranys acceptats i assignacions addicionals |
En un model dens que genera un token cada vegada, dividir l’amplada de banda de memòria pels bytes dels pesos residents dona una estimació aproximada basada només en l’amplada de banda. A 448 GB/s i 11.8 GB de pesos, el quocient és d’uns 38 tokens per segon. Les lectures de memòria cau i el càlcul afegeixen feina, mentre que la descodificació especulativa i el batching canvien les assumpcions.
No tractis aquest quocient com un límit superior universal. Una taxa de sortida més alta no invalida automàticament un benchmark. Comprova si una passada del model objectiu ha acceptat diversos tokens d’esborrany.
La predicció multí-token, o MTP, necessita un model i un runtime compatibles. Compara execucions activades i desactivades amb context ocupat curt i llarg. Els pesos addicionals i l’estat de l’esborrany consumeixen memòria, però cap regla universal obliga a desactivar MTP després de 32K tokens.
Mesura la primera resposta
Prefill processa el prompt abans de generar. Decode produeix la resposta. Un decode ràpid amaga una primera resposta lenta quan la tasca comença amb un prompt gran no emmagatzemat.
Divideix els tokens del prompt no emmagatzemats pel rendiment de prefill mesurat per estimar el temps de processament. Per a un prompt nou de 30,000 tokens, dues taxes il·lustratives produeixen aquestes esperes:
| Taxa de prompt d’exemple | Temps de processament calculat |
|---|---|
| 750 tokens/s | 40 segons |
| 150 tokens/s | 200 segons |
Aquests exemples descriuen el temps de processament, sense càrrega del model ni sobrecàrrega de la petició. La llargada del prompt, la mida del batch, el format del model i el backend afecten la taxa mesurada.
Mesura per separat una petició freda i una continuació amb un prefix reutilitzable. Reutilitzar el prefix evita processar part de l’entrada repetida. Registra el temps fins al primer token juntament amb la taxa de decode i la durada total de la tasca.
Compara configuracions GPU completes
Compara junts el preu de compra, la memòria útil, l’amplada de banda i el camí de programari. Una targeta més barata perd l’avantatge si la càrrega necessita funcions no compatibles o tarda més que el teu objectiu de latència.
| Targeta d’escriptori de 16GB | Amplada de banda de memòria |
|---|---|
| RX 9060 XT | 320 GB/s |
| RTX 5060 Ti | 448 GB/s |
| RX 9070 | 640 GB/s |
| RX 9070 XT | 640 GB/s |
Les especificacions de la RX 9070 d’AMD i les especificacions de la RX 9070 XT confirmen la capacitat de 16GB i fins a 640 GB/s d’amplada de banda. La comparació 640 amb 448 dona aproximadament un 43% més d’amplada de banda teòrica. Aquestes especificacions no impliquen una millora d’inferència del 43%.
Tria benchmarks amb el model i el backend previstos. Per a prompts curts i generació sostinguda, dona més pes al rendiment de decode. Per a l’anàlisi de repositoris, prioritza el prefill fred, la velocitat amb context llarg i acabar la tasca correctament. Comprova el programari disponible abans de comprar cap proveïdor.
Etiquetes de Mac i portàtils
Un Mac amb Apple silicon de 16GB comparteix la memòria entre CPU, GPU, sistema operatiu i aplicacions. Una GPU discreta de 16GB té memòria de vídeo dedicada al costat de la RAM del sistema. Aquestes capacitats no descriuen pressupostos de model equivalents.
Apple exposa una mida recomanada del conjunt de treball de GPU . Inspecciona el límit que informa el runtime i la pressió de memòria del sistema. Deixa espai per a macOS i les altres aplicacions en lloc de pressupostar tota la memòria compartida per a inferència.
En portàtils, comprova l’SKU exacte del fabricant, la memòria dedicada, el límit de potència de la GPU i la refrigeració. La pàgina de la família RTX 5060 de NVIDIA enumera variants de memòria de la RTX 5060 Ti d’escriptori. El nom de la família no estableix 16GB i els resultats d’escriptori no estableixen el rendiment d’un portàtil.
És rendible tenir-la?
La propietat és rendible quan els càrrecs d’allotjament evitats superen els costos operatius i recuperen la compra del maquinari. Comença amb un exemple només de sortida: una targeta de $789, 35 tokens de sortida/s, 180W durant la generació, electricitat a $0.18/kWh i $2.95 per milió de tokens de sortida allotjats. Són entrades il·lustratives. Substitueix-les pel teu preu, potència mesurada, tarifa elèctrica i preu del proveïdor.
Hours per million output tokens = 1,000,000 ÷ 35 ÷ 3,600 = 7.94
Electricity per million = 7.94 × 0.180 kW × $0.18/kWh = $0.257
Savings per million = $2.95 - $0.257 = $2.693
Break-even output = $789 ÷ $2.693 = 293 million tokens
Continuous generation time = 293 × 7.94 ÷ 24 = about 97 days
Amb vuit hores de generació ininterrompuda al dia, el mateix càlcul triga uns 291 dies. Vuit hores amb un assistent obert són diferents de vuit hores generant tokens.
Amb un preu de sortida allotjat de $0.16 per milió, l’electricitat local ja costa més que l’allotjament en aquest escenari. No hi ha un punt d’equilibri positiu només de sortida sota aquestes assumpcions.
Fes servir el preu actual dels models d’OpenRouter del proveïdor triat, incloent els càrrecs d’entrada i d’entrada en memòria cau. Mesura l’energia de tot el sistema, inclòs el prefill. Afegeix actualitzacions, energia en repòs, manteniment i valor de revenda esperat. Compara la feina acceptada, perquè els reintents i les diferències de qualitat canvien el cost per tasca.
Quan afegir memòria
Supera 16GB quan la teva càrrega mesurada excedeixi el context disponible amb qualitat i latència acceptables. Les sessions diàries llargues d’agents, les peticions concurrents o els pesos de més precisió fan útil una capacitat superior.
Dues targetes de 16GB necessiten suport explícit del runtime. No es converteixen en una assignació transparent de 32GB. Cada dispositiu necessita buffers i la comunicació fa servir la interconnexió de l’amfitrió.
| Estratègia de divisió | Principal compromís |
|---|---|
| Divisió de capes | Capes diferents ocupen dispositius diferents |
| Divisió de tensors o files | El treball dins de les capes afegeix comunicació |
| CPU més GPU | Més capacitat amb un perfil de latència diferent |
Considera una segona targeta quan la placa base, la font, la refrigeració i el backend ja admetin el pla. Compara el cost total amb una sola GPU més gran. La guia de maquinari Qwen de 32GB cobreix aquestes alternatives.
Resolució de problemes i passos següents
Si falla la càrrega, redueix el context i inspecciona les assignacions. Si la velocitat cau durant una sessió, comprova el context ocupat i l’offload a CPU. Si la primera resposta s’encalla, mesura el prefill fred. Si l’ús d’eines falla després de la compressió, compara la mateixa tasca amb un model de més precisió.
Desa una prova repetible amb les instruccions normals, fitxers i sortides de les eines. Registra la revisió del model, la versió del runtime, la precisió de la memòria cau, el context ocupat, la memòria màxima, la latència del primer token, la velocitat de decode i si la tasca ha passat. Repeteix prop de la sessió més llarga prevista.
Fes servir la guia de models locals i context per comparar alternatives més petites. Tria el model més petit que compleixi els requisits de qualitat i reserva prou memòria per a tota la tasca. Amb aquestes condicions, 16GB són un objectiu útil per a una estació de treball.
Related Posts