Enrutament de proveïdors d’OpenRouter: qualitat del model, límits de tokens i costos reals
Table of Contents
L’enrutament de proveïdors d’OpenRouter determina quin servei d’inferència respon a la teva sol·licitud. Dues crides amb el mateix nom de model encara depenen dels límits de l’endpoint, dels paràmetres admesos, del programari de servei i de les preferències d’enrutament. Si les respostes es fan més curtes o fallen les crides d’eines, revisa aquestes diferències abans de culpar la quantització.
Punts clau
- Les etiquetes de precisió descriuen un format numèric, no una puntuació d’exactitud.
- Els límits de l’endpoint determinen el context disponible, la longitud de sortida i el suport de funcions.
- L’enrutament explícit necessita una política de fallback i una preferència de proveïdor.
- Auto Exacto millora la selecció amb senyals de qualitat i ofereix una ruta opt-in per a sol·licituds sense eines.
- El cost efectiu inclou sortida, memòria cau, reintents i finalització correcta de la tasca.
Requisits: Coneixement de les sol·licituds JSON i accés a la configuració d’OpenRouter de la teva aplicació. La inspecció dels endpoints usa una API pública. Enviar sol·licituds de model necessita una clau d’API i genera càrrecs. Torna a comprovar les metadades abans de repetir un exemple datat.
Temps i dificultat: Uns 20 minuts per a una revisió inicial. Nivell intermedi. Una comparació útil entre proveïdors requereix proves addicionals amb prompts representatius.
Què omet el nom del model
Un identificador de model selecciona el model sol·licitat. El proveïdor executa el servei d’inferència, amb la implementació del model, els límits de tokens i l’analitzador de crides d’eines. Un benchmark del model no valida tots els serveis que allotgen aquests pesos.
| Propietat de l’endpoint | Què cal comprovar |
|---|---|
| Longitud del context | Espai per al prompt, historial, resultats d’eines i generació |
| Longitud màxima de completion | Límit de sortida per a la tasca |
| Paràmetres admesos | Eines, sortida estructurada, mostreig i controls de raonament |
| Quantització | Format declarat en comparació amb la versió original |
| Preus | Entrada, sortida, lectures de memòria cau i càrrecs addicionals |
| Comportament del servei | Qualitat, errors d’anàlisi, latència i reintents |
L’enrutament bàsic afavoreix els preus més baixos entre candidats sans. OpenRouter documenta una ponderació inversa al quadrat del preu. En l’exemple simplificat, un candidat d'1 dòlar rep nou vegades el pes de selecció d’un candidat de 3 dòlars. Són pesos relatius, no una garantia per a la pròxima sol·licitud. L’ordre explícit, la classificació, la memòria cau i l’enrutament per qualitat també afecten la selecció. Consulta la documentació d’enrutament de proveïdors .
La ponderació del preu no demostra la factura més barata per a la teva càrrega. L’exemple no fixa una barreja universal d’entrada i sortida. No dedueixis la probabilitat de selecció només del preu d’entrada.
Llegeix la precisió en context
La quantització desa valors numèrics amb una representació reduïda. El seu efecte depèn del model, del mètode i de la implementació d’inferència. Una precisió inferior requereix proves, però l’etiqueta sola no demostra que un proveïdor hagi canviat els pesos originals.
GPT-OSS ofereix un exemple concret. La documentació de llançament de gpt-oss-120b d’OpenAI indica que els pesos experts del model de barreja d’experts usen MXFP4 i que les avaluacions van usar la mateixa quantització. Una etiqueta de quatre bits és coherent amb la versió publicada. No prova una degradació addicional del proveïdor.
L’upcasting converteix valors desats en una representació més ampla. Convertir un checkpoint ja quantitzat a BF16 no recupera la informació descartada. Convertir un checkpoint original de més precisió a quatre bits introdueix un canvi separat que cal avaluar.
| Observació | Conclusió admesa |
|---|---|
| Checkpoint MXFP4 natiu | Els pesos experts de quatre bits formen part de la versió |
| Etiqueta BF16 de l’endpoint | Format declarat més ample, sense prova de respostes millors |
| Precisió desconeguda | Metadades absents, sense prova de degradació oculta |
| Etiquetes de precisió iguals | Evidència insuficient de comportament equivalent |
Les etiquetes iguals tampoc descarten diferències de quantització. No indiquen quins tensors es van quantitzar, quina calibració es va usar ni quins kernels s’executen. Prova l’endpoint complet en lloc de tractar la profunditat de bits com una classificació de qualitat.
Comprova el pressupost de tokens
curl --fail --silent --show-error \
  'https://openrouter.ai/api/v1/models/openai/gpt-oss-120b/endpoints' \
  | jq '.data.endpoints[] | {
      name,
      provider_name,
      context_length,
      max_completion_tokens,
      supported_parameters,
      quantization,
      pricing
    }'
L’API d’endpoints exposa metadades del proveïdor per a un model. Aquesta ordre necessita curl i jq. Inspecciona la
resposta actual de l’endpoint gpt-oss-120b
abans de seleccionar un servei. Tracta els camps absents o nuls com a desconeguts, no com a il·limitats. Desa una captura local datada quan comparis resultats.
Una comprovació del 5 d’octubre de 2026 va retornar aquests límits anunciats per a gpt-oss-120b. Són valors de metadades, no longituds de completion mesurades, i els proveïdors els canvien amb el temps.
| Proveïdor | Tokens de context | Màxim de tokens de completion |
|---|---|---|
| DigitalOcean | 128,000 | 4,096 |
| Novita | 131,072 | 32,768 |
| Together | 131,072 | 117,964 |
La longitud del context i la de sortida són límits separats. Un model de context llarg encara necessita espai per a la resposta. L’historial, les instruccions del sistema i les definicions d’eines consumeixen espai amb el document de l’usuari.
Els tokens de raonament també consumeixen el pressupost de generació en models compatibles. Un límit petit arrisca un raonament incomplet, poca sortida visible o la finalització abans de la resposta final. Inspecciona l’ús i el motiu de finalització en lloc d’assumir pesos més febles. Consulta la documentació de tokens de raonament .
Un max_tokens explícit dona al router una longitud de sortida sol·licitada per comparar-la amb el suport del proveïdor. Tria-la segons les necessitats mesurades i el context disponible. Un valor excessiu redueix l’elegibilitat i no garanteix una resposta més llarga o millor.
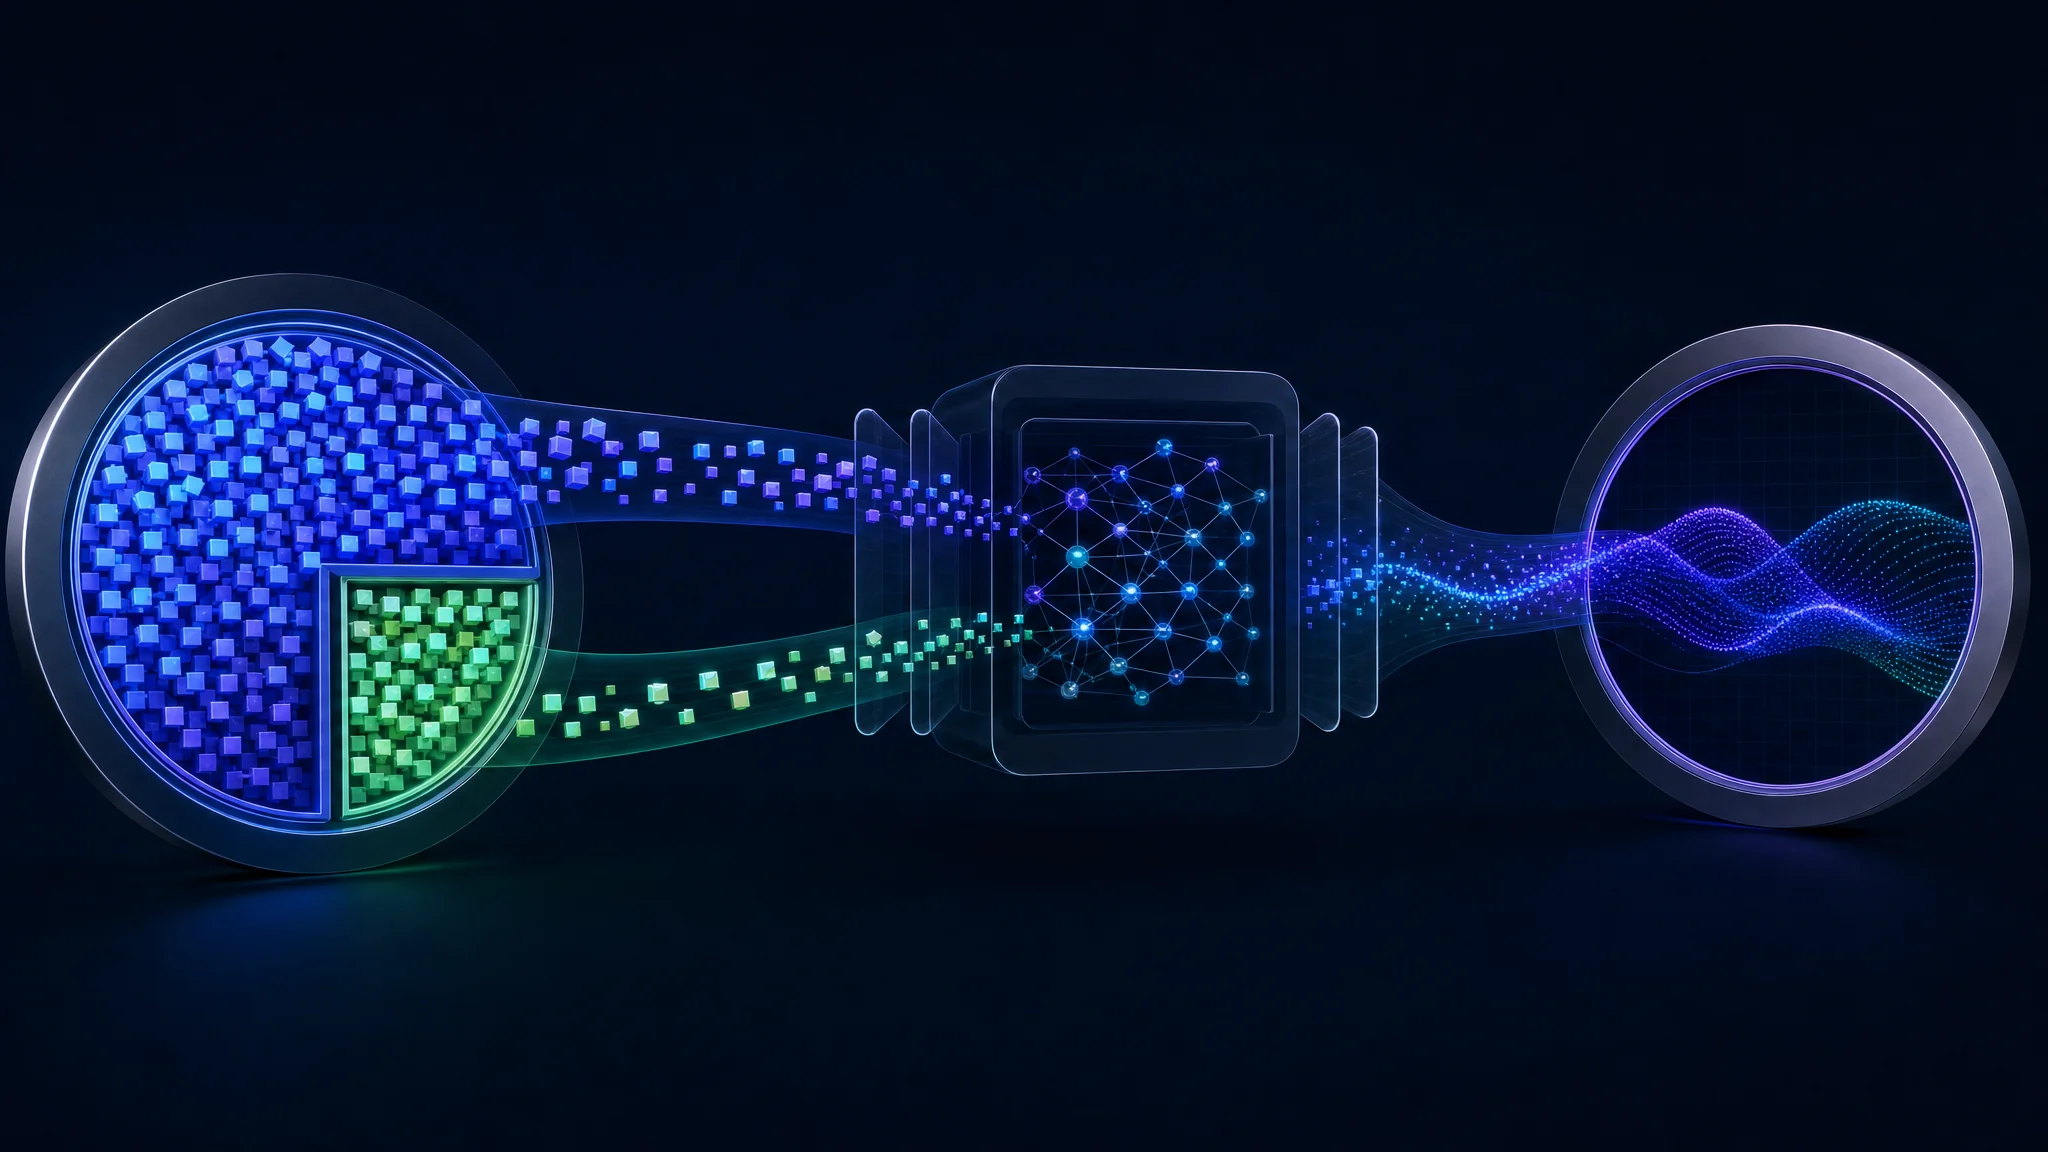
Conceptual token allocation, with reasoning and visible output sharing the completion allowance on supported providers
Exigeix els teus paràmetres
{
  "model": "openai/gpt-oss-120b",
  "messages": [
    {"role": "user", "content": "Explain the failure modes of a retry loop."}
  ],
  "max_tokens": 8192,
  "provider": {
    "require_parameters": true
  }
}
require_parameters té false com a valor predeterminat. En l’enrutament predeterminat, els paràmetres no admesos no sempre exclouen un endpoint. OpenRouter documenta que els proveïdors ignoren paràmetres desconeguts. Posar-lo a true filtra l’enrutament segons el suport declarat.
Les metadades de suport no garanteixen el comportament. Un endpoint que anuncia suport de seed necessita proves de reproduïbilitat. Un endpoint amb eines necessita validació d’esquema i proves de l’aplicació. El filtre evita incompatibilitats conegudes.
Fixa els proveïdors de manera deliberada
{
  "model": "openai/gpt-oss-120b",
  "messages": [
    {"role": "user", "content": "Summarize the supplied incident report."}
  ],
  "max_tokens": 8192,
  "provider": {
    "order": ["REPLACE_WITH_VERIFIED_PROVIDER_SLUG"],
    "allow_fallbacks": false,
    "require_parameters": true
  }
}
Substitueix el marcador pel slug del proveïdor copiat de la llista del model. Envia l’informe en la sol·licitud real. Aquesta plantilla serveix per revisar la configuració, no és executable fins que substitueixis el marcador.
order estableix una preferència. Per si sol deixa actius els fallbacks. Combina’l amb allow_fallbacks: false per limitar l’enrutament als proveïdors indicats. La sol·licitud fallarà si cap compleix la petició o continua disponible.
Les variants de l’endpoint requereixen atenció. Un slug base coincideix amb diverses variants segons les regles documentades. Usa el slug específic quan provis una configuració concreta i torna a comprovar el proveïdor de cada resposta.
quantizations és una llista permesa de formats amb nom, no un mínim numèric. Un array que conté "fp8" selecciona endpoints FP8 coincidents. No inclou BF16 automàticament ni tots els formats amb més bits. Compara primer el checkpoint original i aplica aquest filtre només si la teva avaluació ho admet.
Mantén actiu l’enrutament de qualitat
{
  "model": "openai/gpt-oss-120b:exacto",
  "messages": [
    {"role": "user", "content": "Compare the two supplied incident reports."}
  ],
  "max_tokens": 8192,
  "provider": {
    "require_parameters": true
  }
}
Auto Exacto usa el rendiment, la telemetria d’eines i els benchmarks per rebaixar proveïdors amb baix rendiment. L’ anunci d’OpenRouter de març de 2026 informa d’una reducció del 88% dels errors de crides d’eines de GLM-5, aproximadament del 8% a l'1%. També informa que gpt-oss-120b passa del 5,6% al 3,5%.
Són resultats comunicats pel proveïdor, no una promesa per a la teva aplicació. La validesa d’una crida mesura JSON, noms i esquemes. Una crida vàlida sintàcticament encara necessita arguments i acció correctes.
Les sol·licituds amb eines reben Auto Exacto per defecte quan el model té prou cobertura. Per a altres sol·licituds, :exacto activa l’enrutament de qualitat. La documentació actual el suporta per a resums i xat, a més de l’ús d’eines.
sort: "price", el sufix :floor i un ordre de preu predeterminat del compte desactiven Auto Exacto. Revisa conjuntament els ajustos de l’aplicació i del compte. Consulta la
documentació d’Auto Exacto
abans de combinar controls.
Calcula el cost de la càrrega
El preu d’entrada sol és una comparació incompleta. Aquestes tarifes il·lustratives estan expressades en dòlars per milió de tokens. Mostren l’aritmètica i no són preus actuals.
| Endpoint il·lustratiu | Preu d’entrada | Preu de sortida |
|---|---|---|
| A | $0.03 | $16.00 |
| B | $0.42 | $1.32 |
Workload: 6 million input tokens + 1 million output tokens

A = 6 × $0.03 + 1 × $16.00 = $16.18
B = 6 × $0.42 + 1 × $1.32  =  $3.84

Per million combined input and output tokens:
A = $16.18 / 7 = $2.31
B =  $3.84 / 7 = $0.55
L’endpoint A costa unes 4,2 vegades més per a aquesta barreja malgrat el preu d’entrada inferior. La relació 533 a 1 entre sortida i entrada és una relació entre dues tarifes, no el multiplicador del cost total. Altres proporcions canvien la comparació.
Les unitats de preus de l’API difereixen de les taules. L’API expressa els preus per token. Multiplica per un milió abans de comparar-los amb les tarifes anteriors.
La memòria cau de prompts afegeix una variable. Les lectures, les escriptures i l’entrada sense memòria cau necessiten un compte separat segons les regles de facturació. El text repetit no garanteix un encert. Comprova els tokens i costos informats amb la documentació de memòria cau de prompts .
L’enrutament afecta la continuïtat de la memòria cau. OpenRouter documenta l’enrutament enganxós per a la memòria cau, mentre que l’ordre manual té prioritat. Auto Exacto també reordena proveïdors i de vegades interromp una memòria cau calenta. Compara l’estalvi observat amb els costos de qualitat i reintents abans de canviar la política.
El cost per resultat acceptat és la mètrica útil. Divideix la despesa total, inclosos reintents i errors, entre resultats que compleixen els criteris. Separa els càrrecs no basats en tokens. Un preu baix no compensa tasques repetidament fallides.
Diagnostica una resposta inconsistent
| Símptoma | Primera comprovació |
|---|---|
| Resposta curta o incompleta | Motiu de finalització, límit de sortida, ús del raonament |
| Detalls del document absents | Contingut enviat, límit de context, truncament del client |
| Crida d’eina mal formada | Suport anunciat, esquema de l’eina, comportament de l’anàlisi |
| Mostreig diferent | Paràmetres sol·licitats i suport declarat |
| Despesa inesperada | Volum de sortida, lectures de memòria cau, reintents i canvis de proveïdor |
| Cap proveïdor elegible | Límits en conflicte, llistes permeses i restriccions de fallback |
Conserva l’ID de generació que retorna la resposta. L’ API de metadades de generació exposa proveïdor, ús, cost i finalització. L’ID de sessió agrupa treball relacionat, però no substitueix l’ID de generació.
Desa la sol·licitud amb l’ID. Conserva model, preferències, paràmetres, marca temporal i ús de la resposta. Això fa reproduïble una comparació posterior quan canvien l’enrutament, els preus o les metadades.
Compara endpoints en condicions iguals. Usa el mateix prompt, eines, configuració de raonament i pressupost de tokens. Repeteix diverses tasques representatives. Separa respostes incompletes, crides d’eines no vàlides i respostes incorrectes en lloc de combinar-les en una puntuació sense explicació.
La incertesa del benchmark importa. L’ anàlisi d’Epoch AI descriu variació per implementacions, mostreig i estructures d’agents. Una resposta decebedora no demostra un defecte persistent ni la seva causa.
Guia de l’enrutament d’endpoints
Per ampliar: Debat sobre la qualitat i l’enrutament dels endpoints d’OpenRouter . Torna a comprovar les llistes abans d’aplicar preus, límits o comparacions específiques.
Passos següents
- Inspecciona els endpoints d’un model i registra els límits rellevants.
- Tria una política d’enrutament amb requisits de paràmetres i fallback explícits.
- Prova tasques representatives contra endpoints candidats i enrutament de qualitat.
- Registra el cost dels resultats acceptats amb latència, ús de memòria cau i categories de fallada.
- Torna a comprovar després dels canvis de versions, comportament del servei o preus.
Per a més conceptes bàsics d’IA, continua amb Conceptes bàsics d’IA . Per als permisos dels agents i els controls de validació, llegeix Protegir els sistemes d’IA .
Related Posts