Programació d’IA local en una GPU de 16GB: Strata, OpenCode i Qwen3.8
Table of Contents
Un agent de programació local en una GPU de 16GB és una opció pràctica per a tasques de desenvolupament acotades. Strata i OpenCode combinen inferència local amb edició de fitxers, ordres de shell i execució de proves. Una execució publicada de Qwen3.8-Flash-Next en una RTX 4060 Ti va completar una aplicació, canvis posteriors i un prototip de joc de carreres sense crides d’inferència de pagament.
Substituir una subscripció requereix una prova més àmplia. Els resultats publicats demostren una configuració funcional en una màquina. No demostren paritat amb serveis de programació de pagament entre llenguatges, repositoris o tasques difícils de depuració. El maquinari també inclou 64GB de RAM del sistema, que allotja bona part del model.
Punts clau
- 16GB descriu la memòria de la GPU, no la memòria total necessària per a la configuració publicada.
- La reutilització del prompt importa perquè els agents de programació envien repetidament historials de conversa solapats.
- El raonament necessita un pressupost perquè la planificació deixi espai per al codi i les crides d’eines.
- Passar proves generades és una evidència parcial, i Docker i el joc necessiten comprovacions separades.
- La despesa d’API zero exclou els costos de propietat, l’electricitat i el temps de manteniment.
Requisits previs: un ordinador compatible, prou emmagatzematge lliure per al model seleccionat, Git, Node.js amb npm i familiaritat amb eines de terminal. Reprodueix la configuració IQ3_S publicada amb 64GB de RAM. Usa l’instal·lador actual de Strata per comprovar altres configuracions.
Temps i dificultat: intermedi. Reserva temps per a les baixades i la instal·lació de models grans abans d’avaluar la velocitat de finalització de tasques. Els temps publicats de les tasques exclouen la configuració.
La configuració provada
| Component | Configuració publicada |
|---|---|
| GPU | NVIDIA RTX 4060 Ti, 16GB de VRAM |
| CPU | Intel Core i5-11600K |
| Memòria del sistema | 64GB de RAM |
| Emmagatzematge | SSD NVMe |
| Model | Qwen3.8-Flash-Next, 125B MoE, IQ3_S |
| Motor d’inferència | Strata |
| Agent de programació | OpenCode |
| Context configurat | 65,536 tokens |
| Límit de sortida configurat | 16,384 tokens |
La configuració i els resultats publicats per NetworkCoder proporcionen aquestes xifres. El repositori de proves informa de la càrrega de 46.84GiB de pesos d’experts en 28 segons, amb 4,431 experts que ocupen 8.45GiB de memòria de GPU. Aquestes mesures descriuen l’execució provada, no una assignació garantida en una altra versió del motor.
La compatibilitat actual és més àmplia que aquesta prova. Segons la comprovació del 6 d’octubre de 2026, el projecte Strata documenta targetes NVIDIA i AMD seleccionades amb almenys 12GB de VRAM, a més d’opcions de models més petits per a sistemes amb 32GB de RAM. Aquestes opcions no reprodueixen l’experiment amb GPU de 16GB, RAM de 64GB i IQ3_S. Comprova la GPU exacta, la variant del model i el suport del runtime abans de comprar maquinari.
On viu el model
La mescla d’experts, o MoE, activa un subconjunt de les xarxes expertes d’un model per a cada token. Això redueix el càlcul actiu respecte a usar tots els paràmetres a cada pas. Els pesos restants encara necessiten emmagatzematge i una ruta cap al càlcul.
L’execució híbrida de Strata manté a la GPU els experts usats sovint i conserva la col·lecció d’experts a la RAM del sistema. La CPU calcula els experts no emmagatzemats a la memòria cau, mentre la GPU gestiona els experts emmagatzemats. L’emmagatzematge també admet fitxers del model i dades de consulta. El sistema no introdueix tot el model 125B en 16GB de VRAM.
La memòria de la GPU té usos que competeixen. Les assignacions del runtime, l’estat d’atenció i la memòria cau d’experts comparteixen un recurs limitat. Més espai per al context canvia la capacitat restant de la memòria cau d’experts. Les versions actuals de Strata també admeten streaming de la memòria cau KV, de manera que la ubicació exacta difereix d’una configuració antiga. Consulta la documentació tècnica per a la teva versió del motor.
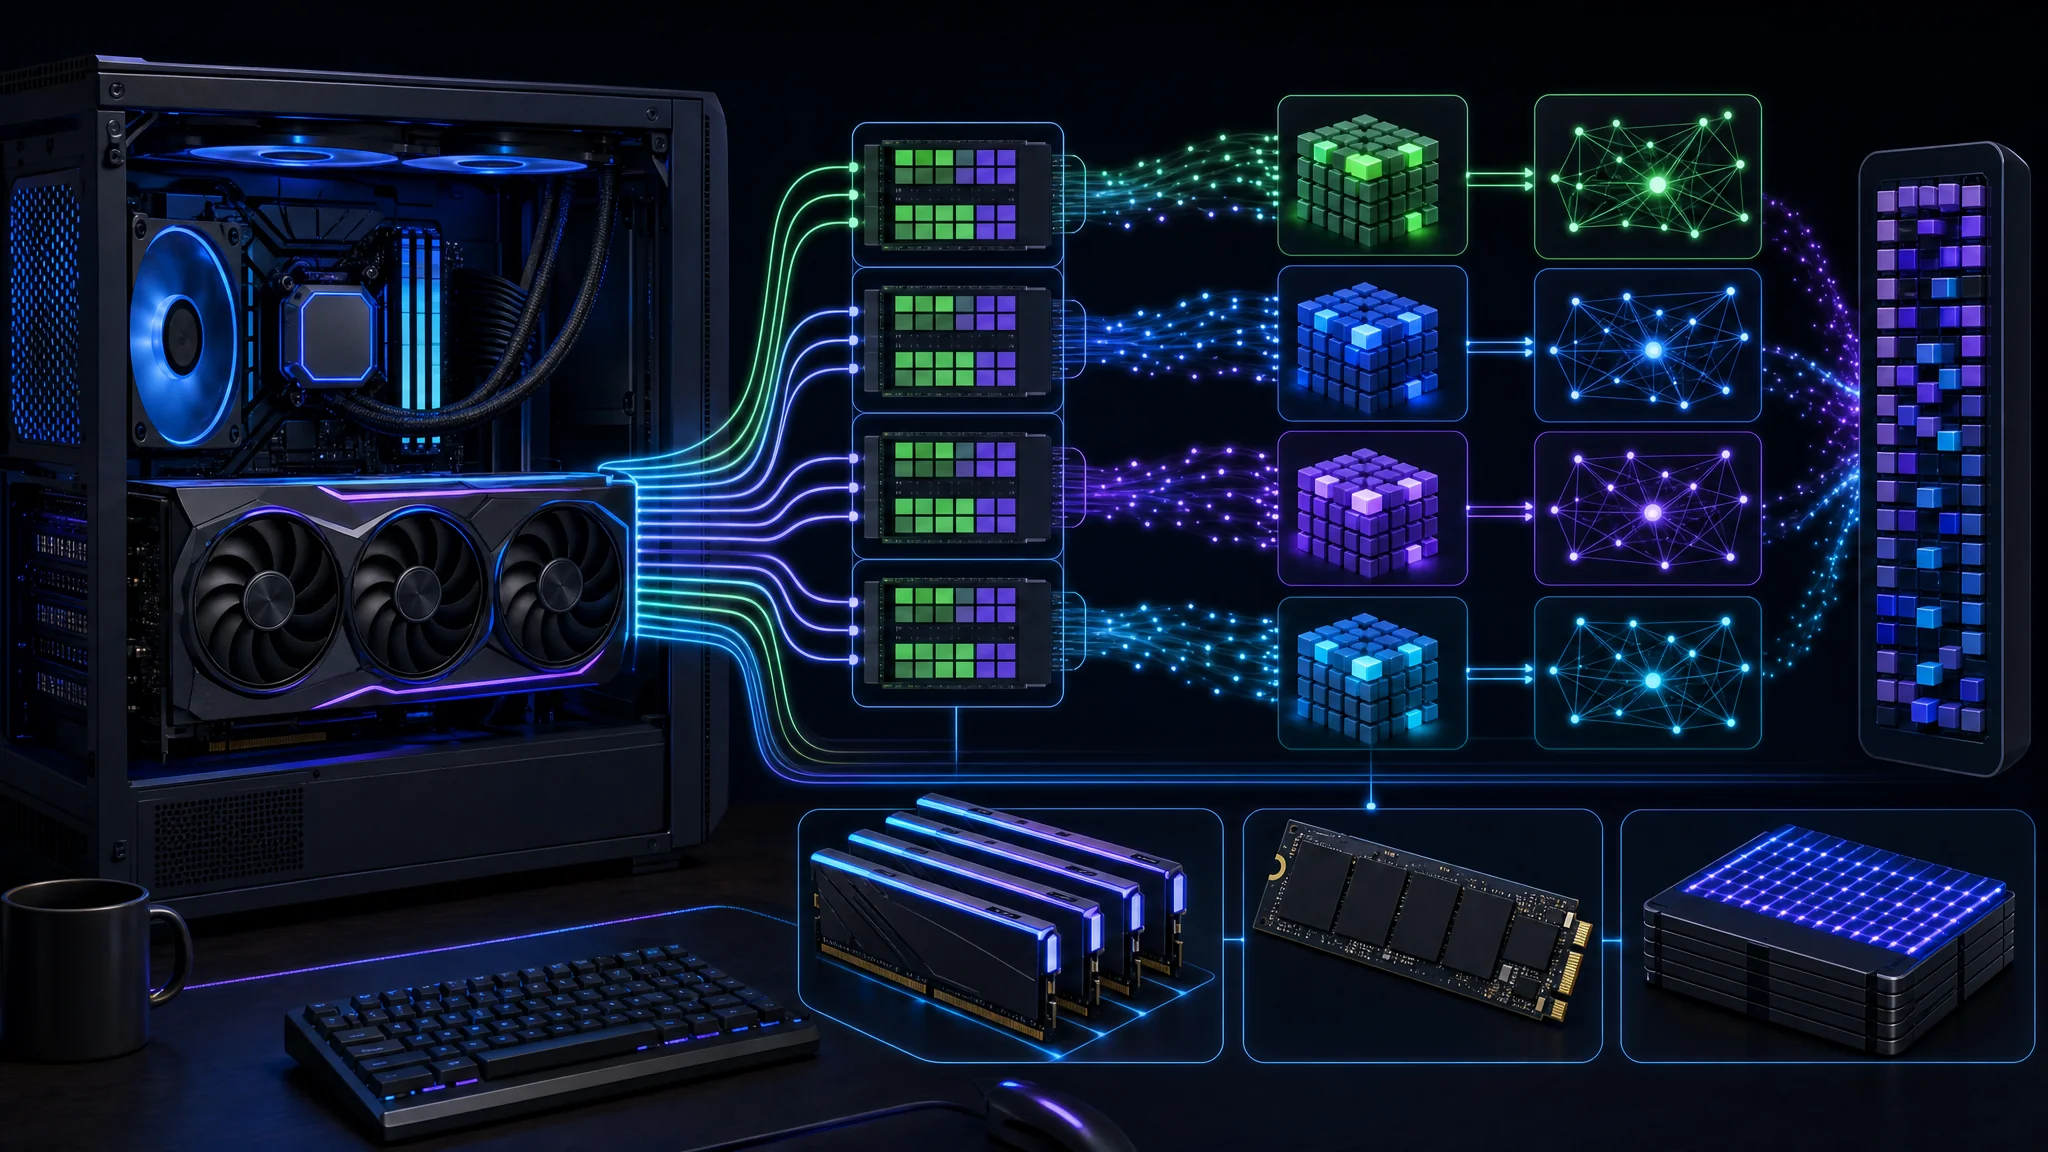
La GPU és una part del sistema d’inferència, juntament amb l’execució de la CPU, la RAM del sistema i l’emmagatzematge
La reutilització del prompt canvia la velocitat
Un agent de programació executa un bucle: llegeix la tasca, sol·licita una acció d’eina, rep el resultat i decideix la següent acció. Els continguts dels fitxers, els errors i els resultats de les proves s’acumulen a la conversa. Els agents també compacten o seleccionen el context, de manera que cada implementació no torna a enviar per sempre tot l’historial sense canvis.
El preompliment processa els tokens d’entrada abans de la generació. La descodificació produeix la resposta. Un sistema amb descodificació ràpida però preompliment repetit lent et fa esperar entre les crides d’eines.
El temps publicat de 44K tokens usava reutilització de prefixos. Strata reutilitzava el contingut de conversa processat abans, amb el prompt creixent preparat en aproximadament un a tres segons. Aquesta és una evidència útil per a una sessió d’agent continuada. No demostra processar 44,000 tokens completament nous des de zero en un segon.
| Mesura | Què cal registrar |
|---|---|
| Prompt fred | Temps per al contingut nou sense estat de prefix reutilitzable |
| Continuació tèbia | Temps després d’afegir el resultat d’una eina al context existent |
| Velocitat de generació | Tokens per segon durant la resposta |
| Durada de la tasca | Planificació, generació, eines, proves i reintents conjuntament |
Dues memòries cau tenen finalitats diferents. La memòria cau d’experts manté els pesos usats sovint a prop del càlcul de la GPU. La reutilització de prefixos evita repetir la feina de l’entrada anterior. Un índex alt d’encerts de la memòria cau d’experts no demostra un encert de la memòria cau del prompt.
Què van demostrar les tasques
| Tasca | Temps publicat | Resultat publicat |
|---|---|---|
| Construir un gestor de tasques | 3m 38s | API Express, interfície, 5/5 proves |
| Arreglar l’edició i afegir dates | 4m 58s | Canvis completats, 6/6 proves |
| Afegir exportació/importació i empaquetatge | 3m 48s | 7/7 proves, compilació Docker no verificada |
| Joc de carreres, primer intent | 6m 35s | Sortida esgotada durant el raonament, sense codi |
| Joc de carreres, reintent amb pressupost | 4m 51s | Joc generat, sintaxi JavaScript comprovada |
El fitxer de resultats publicat registra velocitats de sortida de 48–52 tokens per segon per a la primera tasca, 40–43 per a la segona i 37–44 per a la tercera. «Fins a 52» és un màxim dins d’aquestes observacions, no una velocitat sostinguda per a cada tasca.
Les tres primeres tasques amplien una sola aplicació. Els recomptes 5/5, 6/6 i 7/7 descriuen suites de proves successives. Sumar-los no demostra 18 capacitats independents. Les proves escrites pel mateix agent també necessiten revisió de cobertura i d’assercions significatives.
La recuperació de l’entorn formava part del treball. L’agent es va recuperar d’una ordre de shell inadequada i va identificar un servidor d’aplicació obsolet durant les proves. Són comportaments útils, encara que acabar un procés existent requereix permisos deliberats en un entorn de desenvolupament compartit.
Docker va quedar sense verificar. L’agent va escriure un Dockerfile però no tenia un motor Docker en execució per a la compilació. Passar les proves de l’aplicació fora del contenidor no demostra una imatge funcional. El reintent del joc també va comprovar la sintaxi i va obrir un navegador, mentre l’agent no tenia confirmació visual directa del joc.
Reserva espai per a la sortida
{
  "reasoning_budget_tokens": 8000
}
Fusiona aquesta configuració amb la configuració existent strata-iq3_s.json, conservant els altres camps, i reinicia el model Strata seleccionat. És una configuració de Strata, no un fitxer de configuració substitut d’OpenCode. Verifica el pressupost actiu a la sortida d’inici.
Strata documenta un pressupost de raonament estricte que acaba la fase de pensament i passa cap a una resposta. Un valor a nivell de sol·licitud substitueix el valor predeterminat configurat. La configuració difereix d’una instrucció general d’esforç de raonament com baix o alt.
El primer intent del joc va esgotar la seva assignació de 16,384 tokens durant la planificació. El reintent va aplicar un pressupost de pensament de 8,000 tokens i va lliurar codi. Això dona suport a usar una fase de raonament acotada per a aquesta càrrega. No demostra que 8,000 sigui la millor configuració per a cada tasca.
L’assignació de sortida restant és un màxim, no una garantia de reserva. Si un límit de 8,000 tokens es consumís completament dins d’un límit total de 16,384 tokens, quedarien aproximadament 8,384 tokens abans d’altres despeses. El registre de resultats informa d'11,054 tokens escrits al reintent sense un desglossament complet entre raonament i codi. No ho interpretis com 8,000 tokens de raonament més 11,054 tokens de codi dins del mateix límit.
Usa un pressupost més petit per a edicions estretes, i prova després pressupostos més grans per a tasques que necessitin més anàlisi. Inspecciona la sortida completa del fitxer, l’estat de finalització i els resultats de les proves. Més temps de planificació només és útil si millora el canvi lliurat.
Connecta Strata i OpenCode
git clone https://github.com/Niko1221/Strata.git
cd Strata
./setup.sh
Aquest és el punt d’entrada de configuració per a Linux. Revisa les instruccions d’instal·lació actuals i usa START-HERE.bat per al camí documentat de Windows. Selecciona la variant original Qwen3.8-Flash-Next IQ3_S i un context de 65,536 tokens per aproximar la configuració publicada. Desa la versió del motor i els fitxers de model seleccionats amb les notes del benchmark.
npm install -g opencode-ai
Instal·la OpenCode amb les
instruccions oficials
. En un terminal separat, defineix STRATA_BASE_URL com la base de l’API local que mostra Strata, inclòs el sufix /v1. Mantén la inferència vinculada a la màquina local per a aquesta configuració.
{
  "provider": {
    "strata": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Strata local",
      "options": {
        "baseURL": "{env:STRATA_BASE_URL}",
        "apiKey": "local"
      },
      "models": {
        "qwen3.8-flash-next-iq3_s": {
          "name": "Qwen3.8-Flash-Next IQ3_S",
          "limit": { "context": 65536, "output": 16384 }
        }
      }
    }
  },
  "model": "strata/qwen3.8-flash-next-iq3_s"
}
Fusiona el bloc del proveïdor a ~/.config/opencode/opencode.json, conservant la configuració existent. Això adapta l’
exemple de configuració publicat
carregant l’endpoint local des d’una variable d’entorn. OpenCode documenta els
proveïdors personalitzats
i la
substitució d’entorn
.
local és una credencial de substitució, igual que la configuració local sense autenticació de l’exemple. No protegeix cap servidor. Si la teva instància de Strata activa l’autenticació, proporciona la credencial configurada mitjançant el mecanisme local de secrets adequat.
Inicia opencode en una còpia d’un projecte d’un sol ús i selecciona el model configurat. Verifica el proveïdor seleccionat abans d’enviar codi. La declaració de context del client no augmenta el context configurat del servidor, i una finestra de 65,536 tokens no deixa 65,536 tokens per a l’entrada quan també cal espai per a la sortida.
Inferència local i permisos
{
  "permission": {
    "edit": "ask",
    "bash": "ask"
  }
}
Fusiona aquests permisos inicials amb la configuració d’OpenCode mentre avalues l’agent. La documentació de permisos explica els controls disponibles. Els canvis de fitxers i l’execució de shell afecten la teva màquina independentment d’on s’executi la inferència.
La inferència local no fa que totes les eines siguin locals. Les baixades de paquets, les eines web, les integracions externes i la compartició opcional impliquen serveis de xarxa. Revisa les eines activades abans de tractar repositoris privats. «El model s’executa localment» és una afirmació més limitada que «res surt de l’ordinador».
Resolució de problemes de la primera execució
| Símptoma | Comprova primer |
|---|---|
| Proveïdor no disponible | Strata s’executa i la variable d’entorn arriba al procés OpenCode |
| Model absent de la selecció | L’ID del proveïdor i l’ID del model coincideixen amb la configuració desada |
| Error de límit de context | La longitud del prompt més la sortida sol·licitada caben a la finestra activa del servidor |
| Planificació sense codi | Pressupost de raonament, límit total de sortida i estat de finalització |
| Continuació lenta | Reutilització de prefixos, pressió de memòria, comportament de la memòria cau d’experts i processos en competència |
| L’ordre Docker falla | Hi ha un motor funcional, no només el seu client de línia d’ordres |
Canvia una configuració cada vegada i repeteix la mateixa tasca des d’un estat inicial desat. Això separa una millora de configuració d’un prompt diferent o una prova més fàcil.
Substitueix una subscripció?
| La configuració local mereix una prova | Mantén una altra opció disponible |
|---|---|
| Maquinari compatible existent | Comprar maquinari només per a una càrrega no provada |
| Canvis d’aplicació acotats | Repositoris grans desconeguts i migracions difícils |
| Proves d’acceptació repetibles | Tasques sense maneres fiables de comprovar la correcció |
| Temps per al manteniment del runtime | Treball que requereix poca configuració i poc suport |
La despesa d’API zero és significativa, sobretot quan el maquinari ja està disponible. Exclou l’electricitat, la depreciació del maquinari, l’emmagatzematge i el temps de manteniment de l’entorn. El camp de cost zero mostrat tampoc mesura aquestes despeses.
Una comparació de subscripcions necessita tasques iguals. Executa el mateix repositori inicial, les mateixes instruccions i les mateixes comprovacions d’acceptació en els dos sistemes. Registra els reintents i les correccions humanes juntament amb el temps transcorregut. Inclou el primer intent fallit del joc quan avaluïs tot el flux, en comptes d’informar només del reintent reeixit.
Un agent local útil no necessita una superioritat universal. Si gestiona de manera fiable les teves edicions rutinàries i deixa un petit conjunt de tasques difícils per a una altra eina, ja canvia quins serveis de pagament necessites. Decideix a partir del treball acceptat en els teus projectes.
Demostració i passos següents
Més informació: La demostració de l’agent de programació local 125B . Les mesures publicades anteriors pertanyen a la prova publicada, no a un benchmark independent fet per a aquest article.
- Reprodueix una tasca petita amb criteris d’acceptació fixos i una revisió inicial desada.
- Mesura torns freds i tebis en comptes de tractar la reutilització de prefixos com a velocitat de preompliment freda.
- Verifica l’empaquetatge per separat amb una compilació d’imatge reeixida, inici i comprovacions a nivell de contenidor.
- Inspecciona les proves generades i afegeix casos que la implementació no havia previst.
- Compara el treball completat amb la teva eina de programació actual abans de canviar subscripcions.
Per planificar el maquinari, llegeix la guia de models d’IA locals i context de GPU . Per al comportament dels models allotjats, consulta l’encaminament de proveïdors i els costos d’OpenRouter .
Related Posts